
小鹏 GroundingPI:先让机器人弄清“杯子在哪”,再教它抓取
作者:陈一帆
小鹏联合北大、港大等八家机构发布 4B 具身感知模型 GroundingPI:训练时不使用动作标签,在 34 项感知基准的 11 类能力等权平均中得到 73.68,高于 GPT-6 Astra 的 71.54。跑分领先,但适用边界也清楚。
陈一帆
小鹏 GroundingPI:先让机器人弄清“杯子在哪”,再教它抓取
11 月 4 日,IT之家报道,小鹏集团联合北京大学、香港大学等高校发布具身感知基座模型 GroundingPI:约 40 亿参数,训练全程只使用不带机器人动作标签的数据,在 34 项公开感知基准的 11 类能力等权平均中得到 73.68,高于 OpenAI 的 GPT-6 Astra 的 71.54 。时间线也值得注意:论文 9 月 30 日就已挂上 arXiv,这次是首次公开对外发布 。
先要解决的一个问题
厨房场景里,让机器人“递右边那个杯子的把手”,它得先知道杯子和把手在画面中的具体位置,并用边界框标出来 。很多 VLA 模型从通用视觉语言模型那里继承了感知能力,可识别和定位并不能直接等同:识别得出来,不等于能准确定位 。
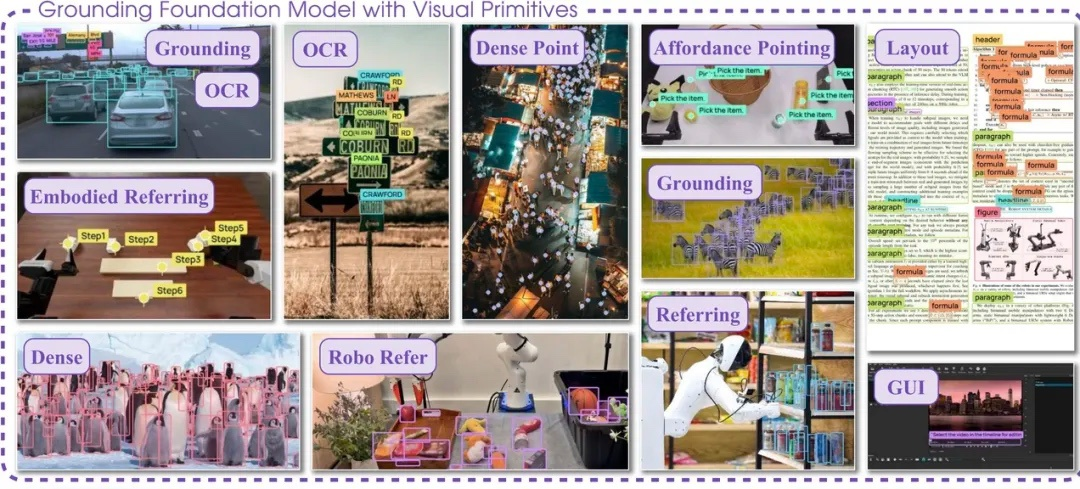
GroundingPI 的做法是,把画面拆成点、框这类视觉基元,再当作基础构件使用:先做多模态与空间预训练,再做监督微调,并加入 GRPO 强化学习,分阶段训练,覆盖通用检测、密集小目标、指代定位、文字识别、文档版面、界面元素、机器人空间定位等 11 类能力 。名字也说得很直白:Grounding 是视觉定位,PI 是 Physical Intelligence(物理智能)。论文里还有一个有意思的发现:文字识别(OCR)这类训练对整体感知学习有催化作用 。
跑分领先说明两件事
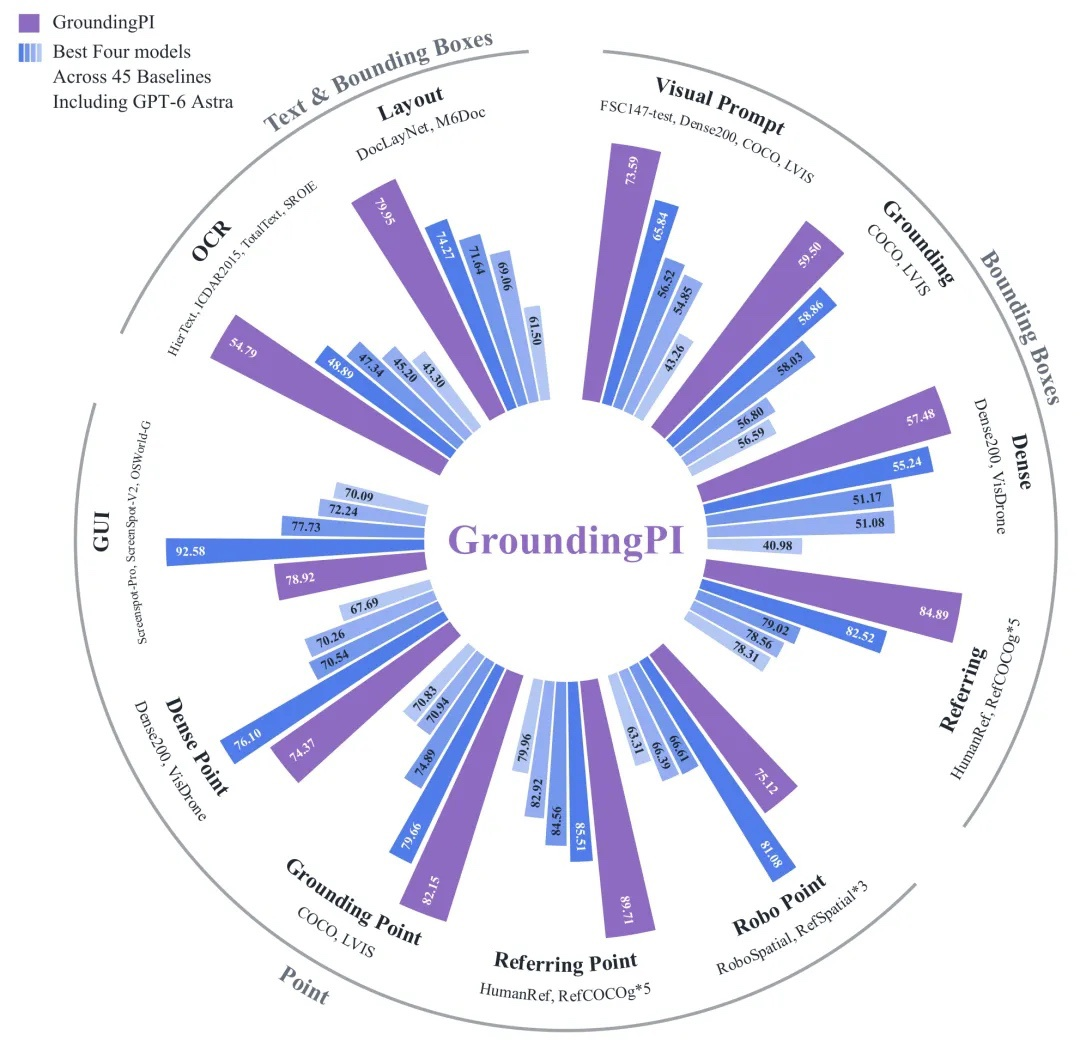
一是小模型可以很专门。4B 的专用定位模型在定位专项上超过更大的通用模型,原因在于任务设计和数据配比,而不在参数的绝对规模 。
二是示教数据能省。把 GroundingPI 当作动作模型的视觉基础,在仿真基准 RoboCasa-GR1 上只用 50% 的人工示教数据,成功率就超过所有对照模型用 75% 数据的成绩 。机器人每完成一个新任务,通常要人工采集千百条示教;少一半数据还能做得更好,直接对应的是部署成本 。换环境也更稳:RoboTwin 2.0 的四个分布外设置全部排名第一,相对最强对照最高提升 24.8% 。对工厂里的散料分拣、料箱清点这类高密度场景,官方给出了“一套权重跨工位复用”的实验支撑 。
也要说清它的适用边界
六个下游评测里它排第一的是五个:RoboCasa-GR1 的分布内评测是 37.75%,略低于 RynnBrain 的 39.00% 。自动驾驶 nuScenes 开环评测平均 L2 误差 0.296 米,比 Qwen3-VL-4B 的 0.301 米只是温和改善;论文也明确说,这些结果不能证明闭环性能,也没有测路牌识别的延迟 。
评测标准也要说清楚:34 项基准、11 类等权平均、44 个对照模型都是论文自己设定的;Astra 是通用前沿模型,并不专用于定位。所以更准确的说法是“专项小模型在专项上超过通用大模型”,直接说“超越 GPT-6”就夸大了 。
为什么是小鹏
小鹏同时做汽车和机器人,两条产品线都需要感知,因此一个感知底座可以在机器人操作和自动驾驶两边复用 。合作名单比“北大、港大”更长:还有伯克利、普林斯顿、新加坡国立、清华和港科大(广州),共八家机构 。
论文、代码和模型权重都已公开 ,官方也说明目前仍是科研原型阶段 。对喜欢动手的人来说,这比跑分更值得关注:分数是可以复现的,适用边界也写得清楚。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] 小鹏联合北大、港大等发布 GroundingPI 预训练模型,感知模块综合跑分超过 GPT-6 Astra
- [S2] GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
- [S3] GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
- 配图 1:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 2:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 3:来源:groundingpi.github.io(图片署名见原文) · 图片出处
- 配图 4:来源:groundingpi.github.io(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。