
京东攒下10万条机器人作业数据,数采这笔账怎么算
作者:周砚
11月4日乌镇峰会,京东披露具身智能数据采集已覆盖100余个细分场景、累计超10万条真实作业任务,并提出两年采1000万小时人类视频、100万小时机器人本体数据的目标。真机数据稀缺且贵,京东的打法是把零售物流的存量场景折成数据资产,再用'自研底座+开放生态'对外输出。但10万条任务与同行的'小时数'不可直接比,采集方式、成本与用途口径均未公开。
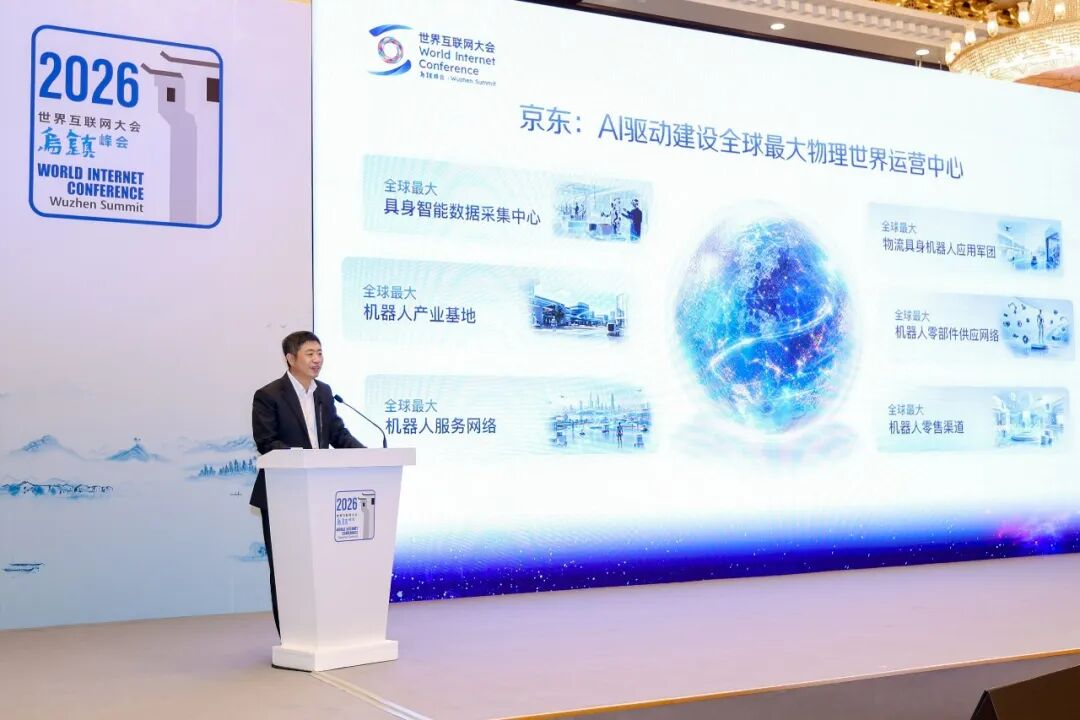
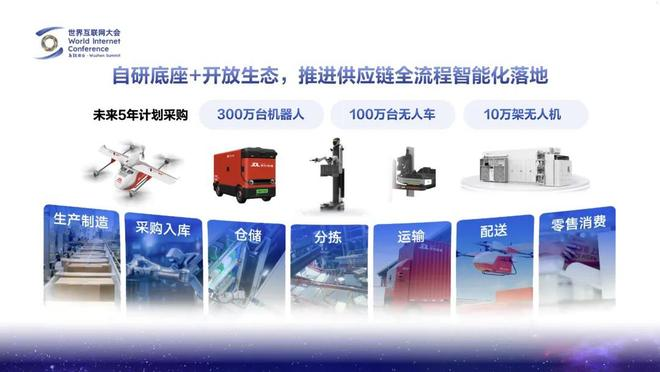
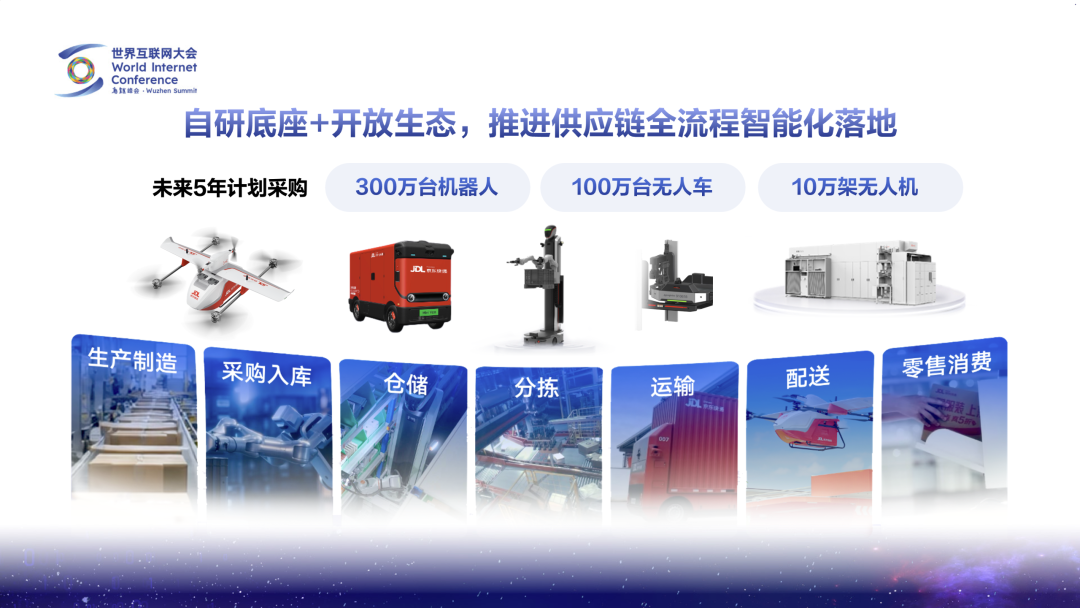
11月4日,在2026年世界互联网大会乌镇峰会的机器人与具身智能论坛上,京东集团技术委员会主席曹鹏给出了一组进度数字:具身智能数据采集已覆盖100余个细分生产服务场景,累计采集超10万条真实作业任务。下一步的目标是两年内采集超1000万小时人类真实场景视频、超100万小时机器人本体运行数据。同场还提到,京东物流计划未来五年采购300万台机器人、100万台无人车、10万架无人机。
数采为什么值钱
具身模型卡住的不是算法和算力,而是物理世界的经验没法批量生产。按行业评论引述的测算,截至2026年初全球合规可用的真机交互数据约50万小时,而训练一个通用具身模型按行业共识需要1000万小时量级,缺口超过99%。这类数字各家口径不一,但方向清楚:一小时真机数据,意味着一个真人操作员在真实场景里实打实花掉一小时,时间压不下去,场景也跳不过。
成本因此难降。业内流传的拆解是,一条30秒真机操作数据的采集成本在10—15元,折合每小时上千元;20万小时约2亿元,百万小时级预训练接近10亿元量级。这是“专门去采”的账。所以更被看好的做法,是让数据从真实生意里自然长出来:特斯拉把产线当采集厂,星动纪元的机器人在顺丰枢纽里边分拣边攒数据,智平方卖一杯咖啡既收钱也收一组数据。这些案例多来自企业自述与媒体盘点,效果强弱还要时间验证。
京东的“自研底座+开放生态”
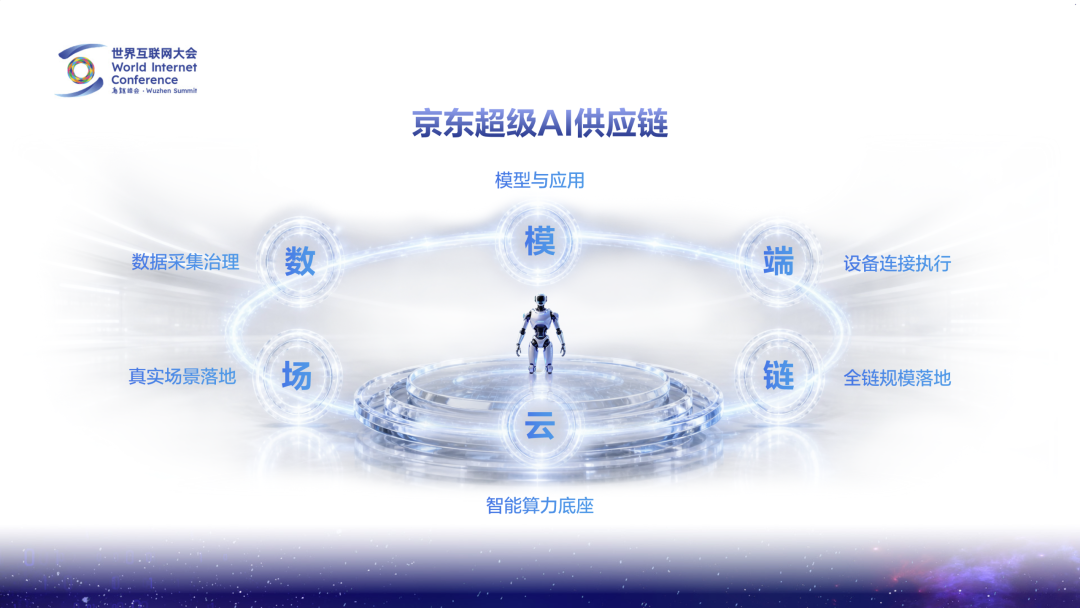
京东手里最硬的牌是存量场景:3800多个仓库、20万多家合作线下药房、1万多家京东MALL、七鲜、养车门店,AI已用于零售、物流、健康、工业等3000多个场景。同样的仓、同样的门店,别人要另搭一套来采数据,京东是本来就在跑。
工具层,京东云自研JoyEgoCam等采集终端,搭了覆盖“采、存、标、训、评、仿、测”的数据服务体系;JoyAI-Sim仿真引擎已完成的测试中,仿真评测与真机评测一致性约90%,效率是真机的3.2倍。承载这些的是宿迁的机器人数据采集中心:2025年10月投用,被江苏省工信厅认定为省级具身智能机器人数据采集中心,新华社今年8月的照片里,采集员正在其中训练机器人。公开规划称将动员内部超10万员工、外部最多50万人参与采集。
“开放生态”落在两处。一是京东启动“京东物理AI加速计划”,第一阶段聚焦具身机器人,在数据、基地、制造、销售、物流、服务六个方向投入;二是智元的具身机器人已进入京东物流智狼仓实测,在真实作业中检验产品边界。对京东,这意味着仓里多了一批自带数据的租客;对机器人公司,这是难得的真实场景,代价是效率被摊在明面上比。
三处口径要留神
10万条“任务”与同行惯用的“小时数”“轨迹条数”不能直接换算。京东没有披露这批任务的采集方式(遥操作、动捕,还是掺了合成数据)、单条成本,以及多少喂自研模型、多少对外供给。1000万小时的大头是“人类视频”,与100万小时“机器人本体数据”不在一个质量层级,视频学习的迁移效率业内仍有争论。至于“全球最大数采中心”和300万台采购,前者是京东自述的定位,后者是五年计划,分年落地量尚未公开。
能确认的是行业在被标准化:工信部批准的《具身智能数据集质量要求及评估方法》今年11月起实施,全国已建成或在建的采集训练工厂至少15座。数采正从手工作坊变成流水线,比的是单位成本和质量。京东的场景密度是真优势,但从10万条走到1000万小时,考验的还是同一件事:愿不愿意持续为一门不直接产生收入的数据生意付账。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] 京东披露具身智能数采进展:覆盖百余细分场景、采集超 10 万真实作业任务
- [S2] 京东曹鹏:未来五年计划采购300万台机器人、100万台无人车
- [S3] 探访京东机器人数据采集中心(3)
- [S4] 為什麼機器人"大腦"比大模型更難訓練?
- [S5] 京东将建成全球最大具身数据采集中心,大布局该怎么期待?
- 配图 1:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 2:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 3:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 4:来源:finance.sina.com.cn(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。