
AI 进机构,先写两份文件:一份管作业,一份管发言
作者:陈一帆
MIT News 十月两场观点问答,一场谈院系怎么给学生的 AI 使用定路径,一场谈公共文本该由谁作答。连起来看,机构要给 AI 定的规矩其实分事前、事后两份:一份写清什么算你的、什么必须自己练,一份写清每段对外文字末端站着谁。两位学者都不主张禁用,分歧之外有共同点,也有各自的证据边界。
机构遇上 AI,可用的做法有两种常见思路,但都不太管用:一是发禁令,二是买检测器。MIT News 十月刊出的两场问答给了第三种思路——把规矩写进流程本身。10 月 8 日那场,受访者是 MIT 统计与数据科学中心主任 Alexander(Sasha)Rakhlin,谈院系怎么安排 AI 在教学和研究里的位置 ;10 月 13 日那场,受访者是媒体艺术与科学教授、建设性传播中心(CCC)主任 Deb Roy,谈公共讨论里每段文字该由谁负责 。两场都是观点访谈,不是新闻,也没有新的实验数据。连起来读,它们关心的是同一个问题的两个方向:机构要在事前、事后各写一份文件。
第一份写在上课之前:什么算你的,什么必须自己练
Rakhlin 的观察从一份作业开始。在越来越多领域,一篇打磨得很漂亮的论文,正在变成越来越弱的个人能力信号 。他没有停在感叹上,而是给了一个偏工程的解释:一个学科里 AI 进步快不快,很大程度上看验证快不快、可不可靠。形式化证明能自动检查,程序能直接跑测试,AI 就能不断生成候选、按结果改进,越转越快 。
所以他主张改的是评分表、奖励表,而不是把 AI 挡在门外。他明确反对把有价值的工作定义成“AI 暂时还做不到的事”,因为这条线会一直往后移。提问、复现、观点综合、有信息量的阴性结果、共享数据集,都值得更多承认 。更实际的一条是:评价一个研究者时,要写清他贡献了什么、对哪些部分负智识上的责任,包括大量工作由 AI 完成的情况;这些要求要落进招聘、晋升、经费,也要对在读和刚入学的博士生讲明白 。
训练这半边更难。算题、写代码、走不通的路、小发现,长期是学生练出直觉和判断力的“练习组”;全交出去,肌肉就不长,哪怕题目因此敢做得更大 。他给出的分界线很好用:分清“不必要的摩擦”和“让专业能力长出来的摩擦”,把提出问题、审计模型输出、复现结果、为自己的选择辩护留作必修 。他也承认边界:不要假设抽象、判断、问题定义永远归人类,大学要准备迎接“AI 在智识工作的许多方面比我们都聪明”的近未来 。这不是禁令的口吻,更像提醒学校别把力气全花在拦水上。
第二份写在发言之后:链条末端得站着人
Roy 的场景在校园外。政策制定的公众意见征集期,本来是一条让规则获得合法性的通道。他举的例子有调查背书:2017 年 FCC 就废除网络中立规则收到 2200 多万条公众意见,纽约州总检察长后来查出近 1800 万条是假的 。当年的造假会留下指纹——模板化文字、重复措辞,所以被抓到。大语言模型把这些指纹擦掉了:每条都流畅、都不一样,审阅者分不出哪些是真人写的 。
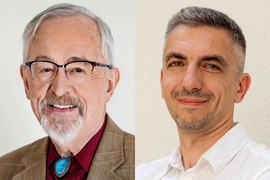
他用了两个日常概念。一个是“发言资格”(standing),借自法律里的诉讼资格:你有没有资格让自己说的话在一个有后果的流程里算数。他举新英格兰的镇民大会——站起来说话的一般是本镇人,外州来的陌生人一开口,全场会想“这人谁啊”。过去到场本身有成本,这层摩擦天然筛掉了没有资格的人,而现在 LLM 把这层边界抹平了 。另一个是“可答性”(answerability):能为自己说的话解释、辩护、更正、补救。两者必须同行,被听见的权利伴随作答的义务 。
关键的一步是他的让步:AI 不是不能用。起草、摘要、找规律,都可以在问责链条里做。一位利益相关者用 AI 起草意见、自己采纳、并准备为它作答,在这种语境下是正当的 。AI 做不到的是锚住链条——末端得有一个能负责的人,一个软件系统没有可失去的东西,责任不会停在它那里 。落到设计上,他给出四条原则:可归属的作者、可分解且可检查的过程、把来源记录当作基础设施、扩大而不是集中发言资格;总规则是“允许自主,不允许无问责”。他也顺手回应了隐私的质疑:机构可以核验一个人、为他的文字背书,而不必公开姓名,“披露义务随权力上升,身份保护随脆弱性上升”。
这里要分清哪些已经在跑:CCC 与 Cortico 合作的对话项目,参与者可以在关键步骤检查并推翻技术输出;原型 VoiceTrace 把每句结论回链到具体发言 。四条原则目前还是设计主张,还不是已经落地的通用标准。
两场问答的差别,和共同的落点
差别在时序。Rakhlin 管事前,把标准写在作业交上来之前;Roy 管事后,文字已经出门,追问谁站出来。共同点更值得记:两人都不喊禁用,都给 AI 留了正经位置;两人都把规矩落在流程结构上——改评价表、改过程,让“谁对哪些内容负责”变成可检查的字段——而不是靠检测工具去猜一段文字像不像人写的;两人都在催机构现在就动手 。
局限也要说清楚:两篇都是观点访谈,没有实证数据;Rakhlin 提到的 IMO 金牌水平、千禧年难题新解法,是他本人的转述,本文未独立核实,问答中提到的那篇 essay 也没有给出处 ;Roy 的 FCC 数字有总检察长调查作依据,相对扎实 。两位学者之间没有证据显示有协同,把两篇连读是编辑的选择,不代表 MIT 的官方政策。
但如果你真要给一个班、一个系定规矩,这两份文件加起来就够了:一份写在事前,说清哪些环节可以借力、哪些必须自己练、成果怎么算;一份写在事后,说清每份对外文字由谁作答、怎么查证。中间的活 AI 可以干很多,两条线的落点却是同一个人——那个能被叫出名字、站出来解释的人。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] 3 Questions: What is the best path forward for AI in academia?
- [S2] Q&A: Building accountability behind our words — and AI’s — in civic conversations
- [S3] Who stands behind the words?
- 配图 1:来源:MIT News | Massachusetts Institute of Technology(图片署名见原文) · 图片出处
- 配图 2:来源:MIT News | Massachusetts Institute of Technology(图片署名见原文) · 图片出处
- 配图 3:来源:MIT News | Massachusetts Institute of Technology(图片署名见原文) · 图片出处
- 配图 4:来源:MIT News | Massachusetts Institute of Technology(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。