
169 道生活题,和一年 20 万美元账单:智能体的能力与成本
作者:周砚
OpenAI 用 LifeVal 的 169 道日常任务给自家模型打分,GPT-6 Astra 在最高推理档拿下 80.6%;同一周,YC 掌门人 Garry Tan 在播客里说自己一年花 10 万到 20 万美元买 token。把考卷和账单放在一起看:分数在 80 分附近放缓,高推理档位几乎不涨分,而重度用户真正买到的,更像是时间和并行处理能力,而不是准确率。
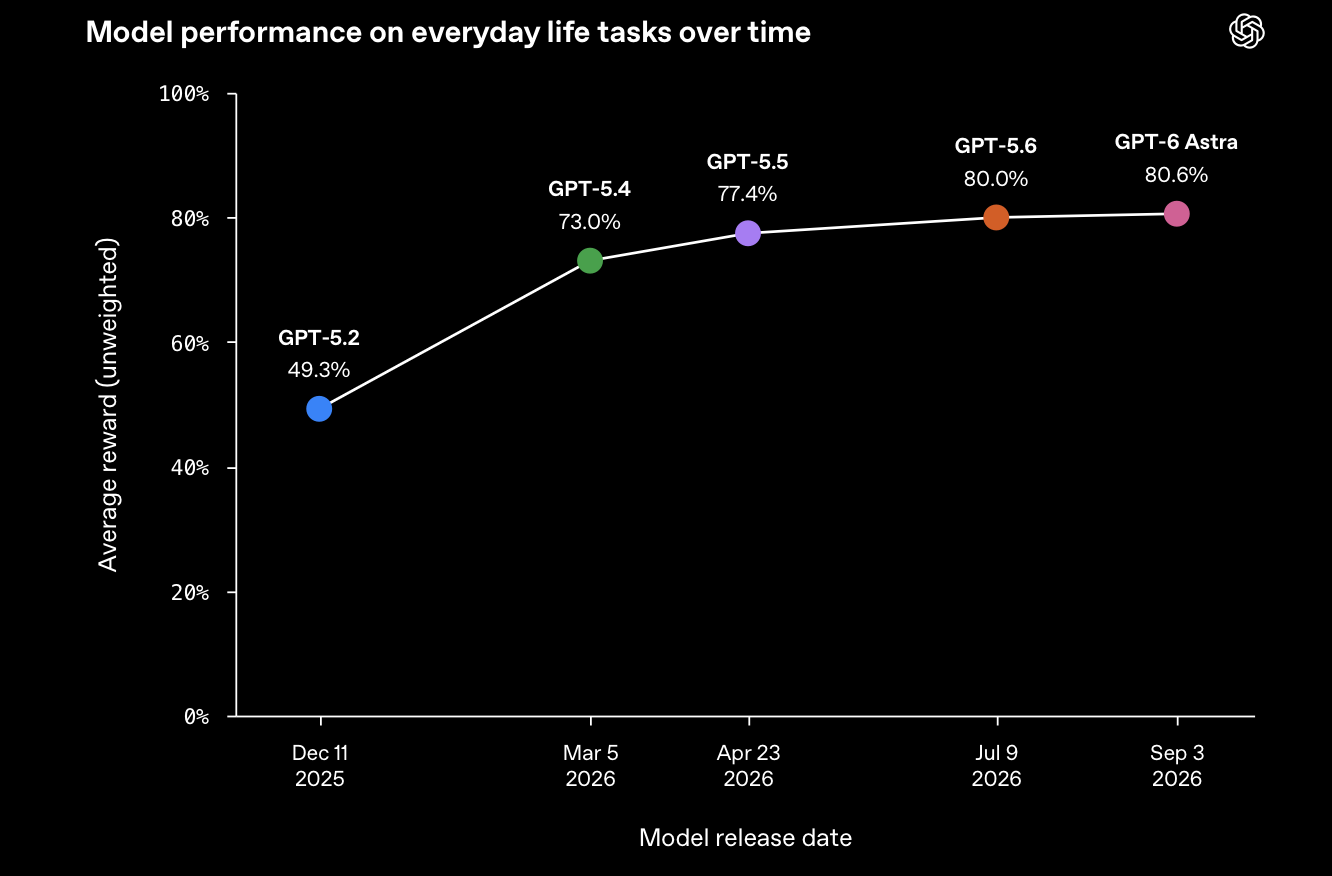
两条消息几乎落在同一周。OpenAI 发布 LifeVal,用 169 道日常任务给自家模型打分;Y Combinator 掌门人 Garry Tan 在 Walter Isaacson 的播客 The Builders 里说,他一年在 token 上大概花 10 万到 20 万美元 。一张是厂商出的考卷,一张是重度用户自己付的账单,放在一起才能看清智能体现在的位置:它能做对多少,以及做对这些要多少钱。
考卷:169 道题,量的是“把事办完”
题不是凭空想的。OpenAI 先看两份时间使用调查,美国劳工统计局的 ATUS 和跨国的 MTUS,弄清人们一天的时间花在哪;再做一次 3,995 人的代表性调查,问他们最想把哪些事交给 AI 助理。两边的交集成了题库 。169 道题落在七类:照护、健康、教育、家务行政、个人财务、购物、政府服务 。
关键是题的形式。每道题给模型一段请求、一份个人背景、一个模拟环境和初始状态,模型要真的动手:浏览离线版网页、填表、处理文件、做模拟交易 。官方举的例子包括搬家后给孩子挑幼儿园、洪水来临前组织志愿队、在 Luzerne 县找一套带独立单元的房子并把产权文件加进购物车 。这些属于办事,不属于问答。
计分:169 个平均数,再平均一次
主指标是平均奖励。算法是先在每道题的多次尝试里取平均,再把 169 个题均分等权平均,满分 1,所以 80.6% 就是 0.806 。图注标着“No WTP weighting”,意思是按付费意愿加权的版本没用在主分数上,而这样一个版本至少被算过或考虑过,只是没公开 。
打分靠细则,而评分器本身是模型。论文说 LifeVal 用了两个由 GPT-5.6 驱动的自动评分器:一个按细则打分,一个检测模型有没有钻测试环境的空子,被判定作弊记 0 分;汇总结果的主评分器是 GPT-5.6 Sol,xhigh 档 。校准也做了一次:在 30 题子集上,17 名训练员给同一次 GPT-5.5 表现打分,人类均分 83.61%,GPT-5.6 给 84.20%,相关系数 0.864 。
分数:最陡的一段已经过去
xhigh 档下,GPT-5.2 在 2025 年 12 月是 49.3%,三个月后的 GPT-5.4 到 73.0%,一次加了 23.7 个点;之后 GPT-5.5 是 77.4%、GPT-5.6 是 80.0%、GPT-6 Astra 是 80.6%,三代合计只加 7.6 个点 。
更有信息量的是按推理档位拆开的那张图。Astra 在 high 档是 80.7%,调到 xhigh 是 80.6%——多想一档,多花 1.4 秒和 2.1K token,分数还低 0.1 。推到 max 才到 82.5%,而 GPT-5.6 在 max 是 82.6%,图表上的成本 9.65 对 20.04,大约两倍(这列成本没标单位,只能当比值看)。换句话说,这类日常任务上,high 往上加钱几乎买不到东西;Astra 相对上一代在同档位只领先不到 3 个点,xhigh 差 0.6,max 追平 。
账单:钱买的是覆盖范围,不是分数
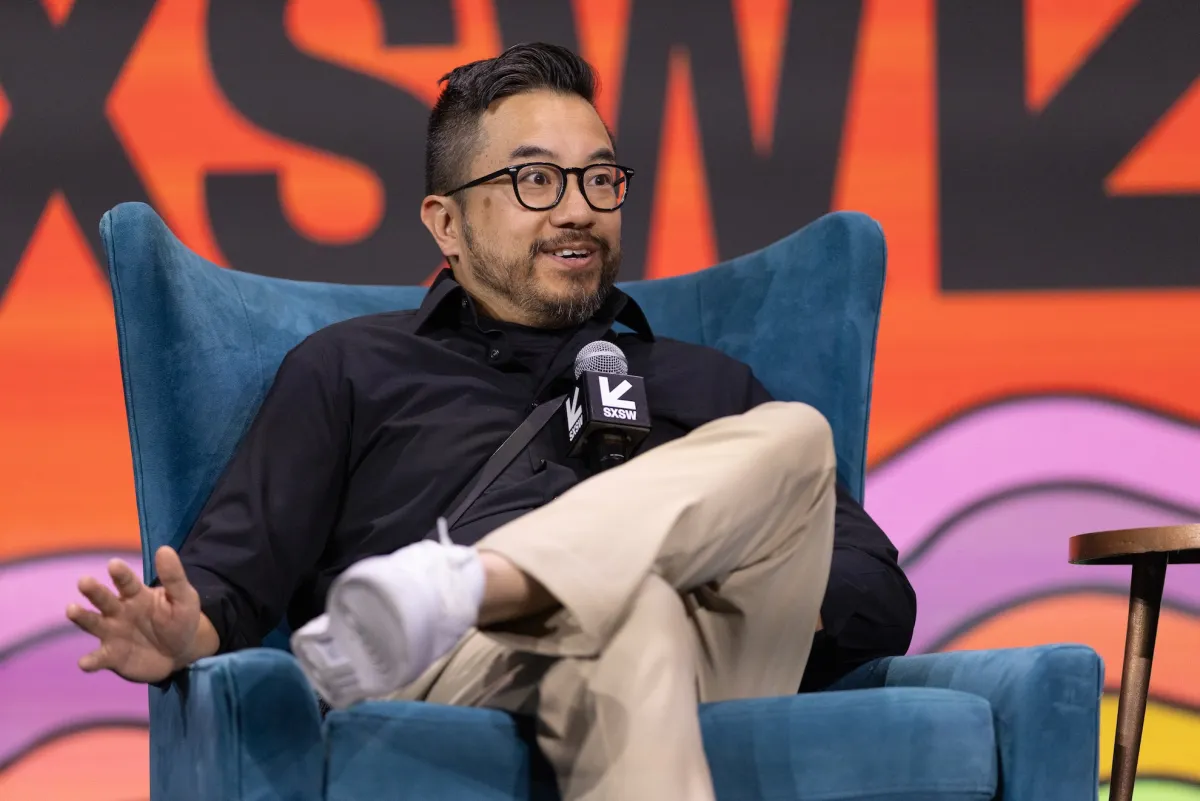
Tan 的原话是“我一年大概花 10 万到 20 万美元买 token” 。这笔钱换来的不是榜单上的百分点,是覆盖范围:智能体读了他全部邮件、Dropbox、Apple Notes,包括 20 年的心理治疗笔记;他用它调研播客嘉宾、写代码、跑各种项目 。他还开源了 23 个 Claude Code 技能(gstack),YC 内部另有一个叫 Stray Light 的智能体,装着历年所有创始人和申请材料 。
他自己给这笔支出划了边界:“现在太贵了”,并说这是“不是人人都有的特权” 。要提醒的是,TechCrunch 没有说明 10 万到 20 万美元是个人口径,还是含 YC 的公司开销 。
怎么读这两组数字
第一,能力曲线在放缓,瓶颈不在“想得更久”。厂商自己的图表显示,把推理档位从 high 加到 max,这 169 道题的分数只多两个点左右,成本翻倍 。对使用者来说,把任务拆清楚、把档位调到 high,比买更高档位划算。这条结论与“卖更高推理档位”的商业叙事相冲突,反而更值得信一分。
第二,重度用户付的钱,买的是时间和并行处理能力,不是准确率。一年 10 万到 20 万美元,只有当你本人的时间比这更贵时才成立;Tan 自己也说普通人复制不了这套开销 。对多数企业,更现实的问题不是“要不要用最强模型”,而是“哪几类任务值得交给智能体”。
第三,80 分附近,价格成了主要变量。每 0.1 分的边际成本在往上走,这既是能力上限,也是定价的难点:厂商想按能力分档收费,但考卷显示高档位的增量已经很小。
证据局限
LifeVal 是厂商自出自评。任务集、评分细则、评分器怎么校准都没有公开,第三方无法复现;榜单上只有 OpenAI 自家模型,连已发布的 GPT-6.1 Sol 和 Terra 都不在图里 。评分器和被评模型同源,0.864 的相关系数只能说明机器评分与人类评分员接近,不能证明细则本身没有偏向 。官方页那五张 90.4% 到 100% 的示例卡是挑出来的,公告只把它们归因于“当前模型”,没写型号、档位和置信区间 。
论文自己也承认几处硬伤:时间使用数据止于 2021 年;付费意愿调查只在美国用英语做;网页缓存不冻结,浏览题的分数会波动;最常见的失败是信息和建议出错,以及漏掉个人对话里的关键细节 。还有一个口径没对上——公告说调查了 3,995 人,论文写 3,837 人完成、1,826 人通过注意力检查,两者关系没有解释 。
所以结论可以克制一点:智能体把日常任务做对八成,这个量级已经不是演示;但剩下那两成,以及支撑这两成的账单,才是产品化的门槛。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] What Is OpenAI LifeVal? The Everyday-Task Benchmark
- [S2] Y Combinator’s Garry Tan uses AI agents so much, he spends up to $200K a year on tokens
- [S3] Y Combinator’s Garry Tan uses AI agents so much, he spends up to $200K a year on tokens
- [S4] OpenAI introduces LifeVal benchmark for everyday AI tasks
- [S5] LifeVal
- 配图 1:来源:apidog.com(图片署名见原文) · 图片出处
- 配图 2:来源:TechCrunch(图片署名见原文) · 图片出处
- 配图 3:来源:Data Phoenix(图片署名见原文) · 图片出处
- 配图 4:来源:Data Phoenix(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。