
1.09亿参数赢过720亿,但这一局只算了“图文对齐”这一项
作者:陈一帆
10月29日,LeCun与Randall Balestriero等人提交论文,把“不同模态模型会收敛到同一套世界表征”的假说写成了定理,并给出实验:1.09亿参数的文本JEPA在与图像编码器的对齐分数上,超过包括Qwen2.5-72B在内的所有被测语言模型。但这场比分只测跨模态对齐,不含推理、写代码等通用能力,论文原话也不是“规模从未起作用”。
文 / 陈一帆
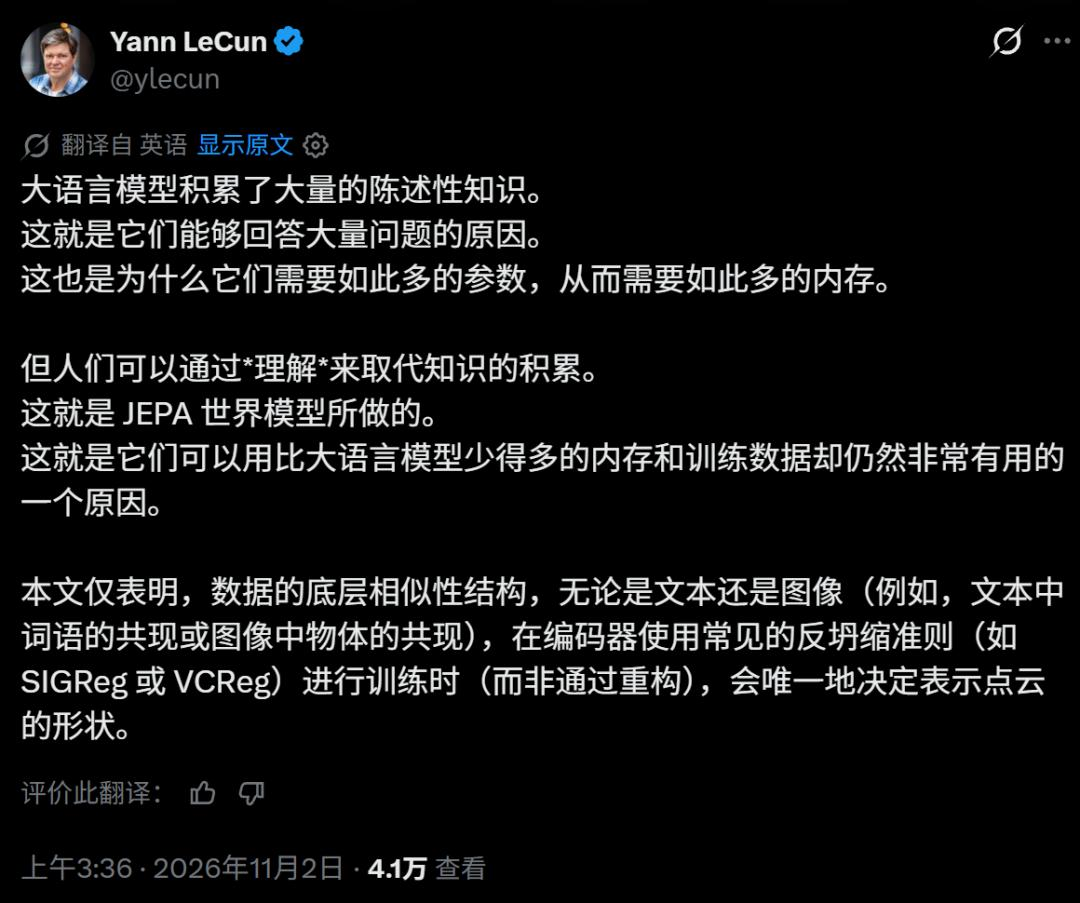
10月29日,Yann LeCun与布朗大学助理教授Randall Balestriero等人在arXiv提交论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》,把“不同模态的模型会收敛到同一套世界表征”这个假说写成了一条定理,并给出配套实验 。11月1日,LeCun在X上解读这篇论文:1.09亿参数的文本JEPA,在与图像编码器对齐这件事上的分数高过所有被测语言模型,包括720亿参数的Qwen2.5 。消息传开后很快被压缩成一句话——“1亿打赢720亿,规模从未起作用”。这句需要拆开看。
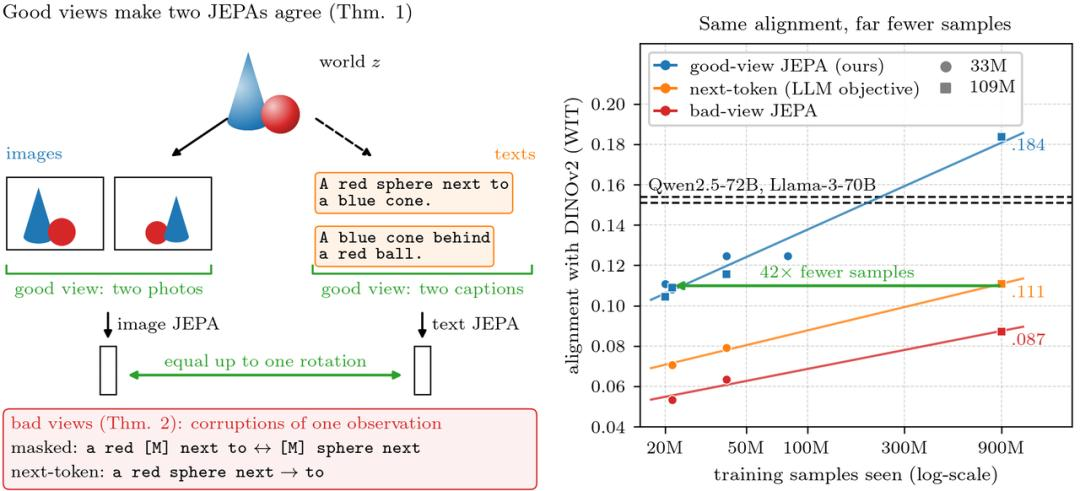
先看比分是怎么算的。研究以DINOv2-B为视觉参照,在WIT-1024基准上测“文本表征和图像表征有多接近”,小模型三次训练平均0.184分,Qwen2.5-72B是0.154,Llama-3-70B是0.151 。比的是对齐分数,不是问答、写代码或做数学题。论文摘要的原话是“正面视图、而非单靠规模,才是构建柏拉图式表征的杠杆” 。规模不是唯一变量,不等于规模没用。
那两边到底在争什么?
主流大模型靠“预测下一个词”训练。这有点像反复听同一段录音、猜下一个字是什么:为了猜准,它必须同时吃下内容、语法、措辞和文体,知识因此积累得又多又杂,参数和内存也就下不来。LeCun的判断是,这些知识里相当一部分是“陈述性”的,能被“理解”替代 。
JEPA的做法换了个学习信号。同一张照片,两个人各写一句描述——“一只狗在草地上追逐皮球”和“草坪上的小狗正在追赶玩具”。论文要求模型把这两句话的向量拉近。措辞不同,能共享的只有场景本身,这被称作“好视图”。反过来,把同一句话遮掉几个词再让模型补全,共享的是表达习惯,被称作“坏视图”;论文把下一token预测也归进这一类,因为它连接的是同一篇文档的前后文 。
差距最后落在数据效率上:达到相近的对齐水平,好视图只需2160万训练样本,下一token预测需要9亿个,相差约42倍;按实际读到的文本token算,约14倍 。论文还展示了两个能跑起来的结果——用一次线性映射把独立训练的视觉编码器和文本模型接起来做图像描述,COCO上CIDEr为0.838;不用图文配对数据拟合映射时,ImageNet-100零样本Top-5到64%,论文称高于此前用8B以下语言模型报告的最好成绩(56%)。
这套说法不是凭空来的。柏拉图表征假说由Huh等人在ICML 2024论文中提出,此前只有经验曲线,没有证明也没有配方,行业能做的就是继续堆规模 。LeCun则多年公开质疑自回归生成路线,认为文本承载不了人类的大部分知识。他现在是AMI Labs的创始人兼主席,此前任Meta首席AI科学家 。
质疑也来得很直接。英伟达研究员Ali Hatamizadeh在同条推文下提问:这只是简单的图文对齐,同等参数和算力下,任何版本的JEPA能在真正的语言建模任务上赢过LLM吗 。另一边,前Google DeepMind研究员Shruti Mishra的说法是“LeCun是对的,只是这个行业不愿承认” 。值得注意的是,LeCun自己的措辞比转发区的欢呼克制得多,他只说数据的相似结构加上防坍塌训练,决定了表征点云的形状 。论文也有明确边界:定理依赖有限世界、可逆观测这类理想化条件,现实实验并未完全满足全部假设 。
对普通用户来说,落点很朴素:这不是一个能下载的模型,短期内也不会改变你手机里的AI助手。它提出的问题倒挺实在——如果模型对世界的理解不够好,原因也许不是不够大,而是训练时没让它对着“同一个场景的不同说法”学。这条路能不能从“对齐分数好看”走到“预测和规划都靠得住”,还得看接下来一两年 。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] LeCun证明了:规模从未起作用,下一token路线效率低 - 36氪
- [S2] Proving and Improving the Platonic Representation Hypothesis with JEPAs
- [S3] LeCun重磅成果单挑Scaling Law!1.09亿参数干翻720亿,训练方式比堆参数更本质_大风号
- [S4] Yann LeCun on X: "LLMs accumulate a lot of declarative knowledge. That's how they can answer a large number of questions. That's also why they require so many parameters and hence so much memory. But one can replace the accumulation of knowledge by understanding That what JEPA world models do.… / X
- 配图 1:来源:m.36kr.com(图片署名见原文) · 图片出处
- 配图 2:来源:m.36kr.com(图片署名见原文) · 图片出处
- 配图 3:来源:m.36kr.com(图片署名见原文) · 图片出处
- 配图 4:来源:m.36kr.com(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。