
OpenAI 发布 LifeVal 基准:169 道生活题,测 AI 能不能帮你找托儿所、办政府手续
作者:许棠
OpenAI 11 月 2 日发布 LifeVal 基准,用 169 项日常任务考 AI 助手,自报最新模型平均 80.6%。但题目不公开、榜单只收录自家模型,判分也由自己完成。
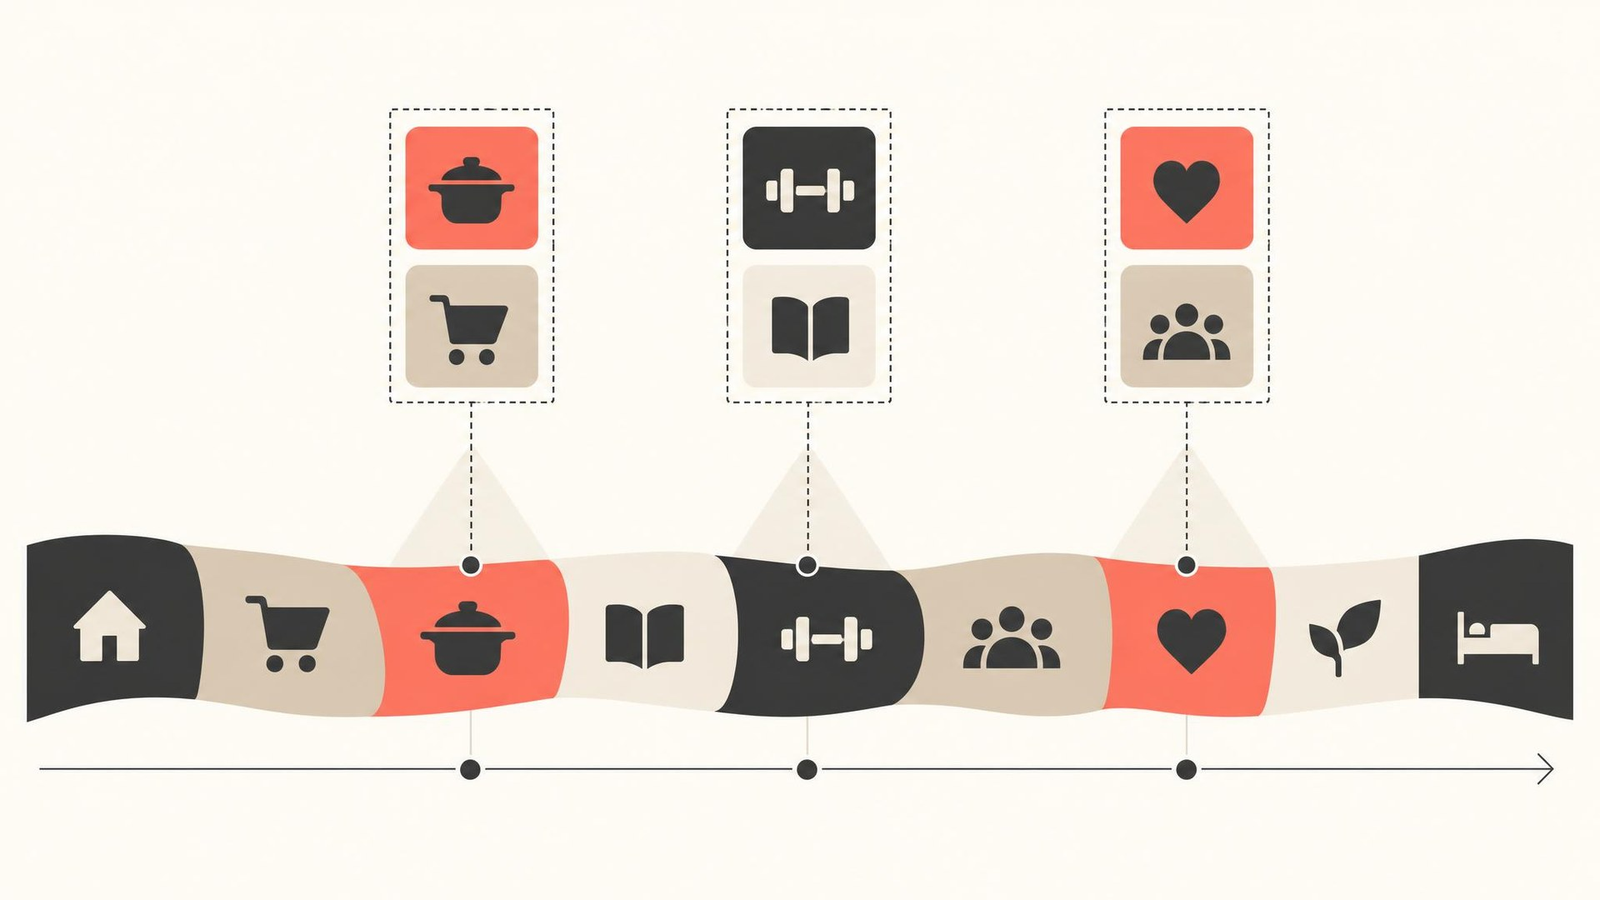
OpenAI 11 月 2 日在官方 X 账号发布新基准 LifeVal,专门衡量 AI 助手能不能把日常琐事办成:找托儿所、办政府手续、管个人账目 。
官方称题目来自数千名 ChatGPT 用户的反馈,问的是最想让个人助理帮什么忙,过去一年已用它改进模型 。配套论文在 11 月 3 日公开:共 169 项任务,选题参考美国时间使用调查和一项付费意愿调查;官方自报 GPT-6 Astra 在高推理档位平均 80.6%,2025 年底的 GPT-5.2 只有 49.3% 。
但这份成绩单由厂商自己评估。题目集、评分细则和判分器都没有公开,无法复跑;榜上只有 OpenAI 自家模型,判卷用的也是自家的 GPT-5.6 。首页展示的五个例子得分在 90.4% 到 100% 之间,属于挑选出来的样本;169 题的平均水平才是 80.6% 。论文里完成问卷的人数是 3,837,与发布材料里提到的 3,995 对不上 。
还有一点值得记住:题目使用了真实用户的 ChatGPT 对话和记忆,官方称已去标识化、个人信息替换为合成数据,目前没有外部核查 。评测从考卷转向生活题,对用户是好消息;但涨了多少分、能不能兑现,仍由厂商自己定义。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] For AGI to benefit all of humanity, it should help people with the everyday tasks that matter most to them. So we built · OpenAI
- [S2] OpenAI’s LifeVal Evaluation Tests AI on Practical Everyday Tasks
- [S3] https://cdn.openai.com/pdf/lifeval.pdf
- [S4] OpenAI introduces LifeVal benchmark for everyday AI tasks
- [S5] What Is OpenAI LifeVal? The Everyday-Task Benchmark
- 配图 1:来源:Unite.AI(图片署名见原文) · 图片出处
- 配图 2:来源:Unite.AI(图片署名见原文) · 图片出处
- 配图 3:来源:Unite.AI(图片署名见原文) · 图片出处
- 配图 4:来源:Unite.AI(图片署名见原文) · 图片出处
0
评论 0
还没有评论,来抢沙发。