
本地跑大模型又快了:Strata 0.2.9 提示词处理最高提速 88%
作者:许棠
Strata 0.2.9 在 Windows 搭配 AMD Strix Halo 运行 Qwen3.8 时,提示词处理速度最高提升 88%,并新增 1 比特 DeepSeek 模型选项;软件免费开源,但 88% 属于开发者自测,条件单一,且新版已更新到 0.2.10。
本地跑开源大模型的 Strata 更新到 0.2.9:在 Windows 上用 AMD Strix Halo(Ryzen AI Max)跑 Qwen3.8,提示词处理(prefill)最高提速 88%,同时新增 Unsloth 的 1 比特 DeepSeek 模型选项 。软件免费、开源(MIT)、不用注册账号 。
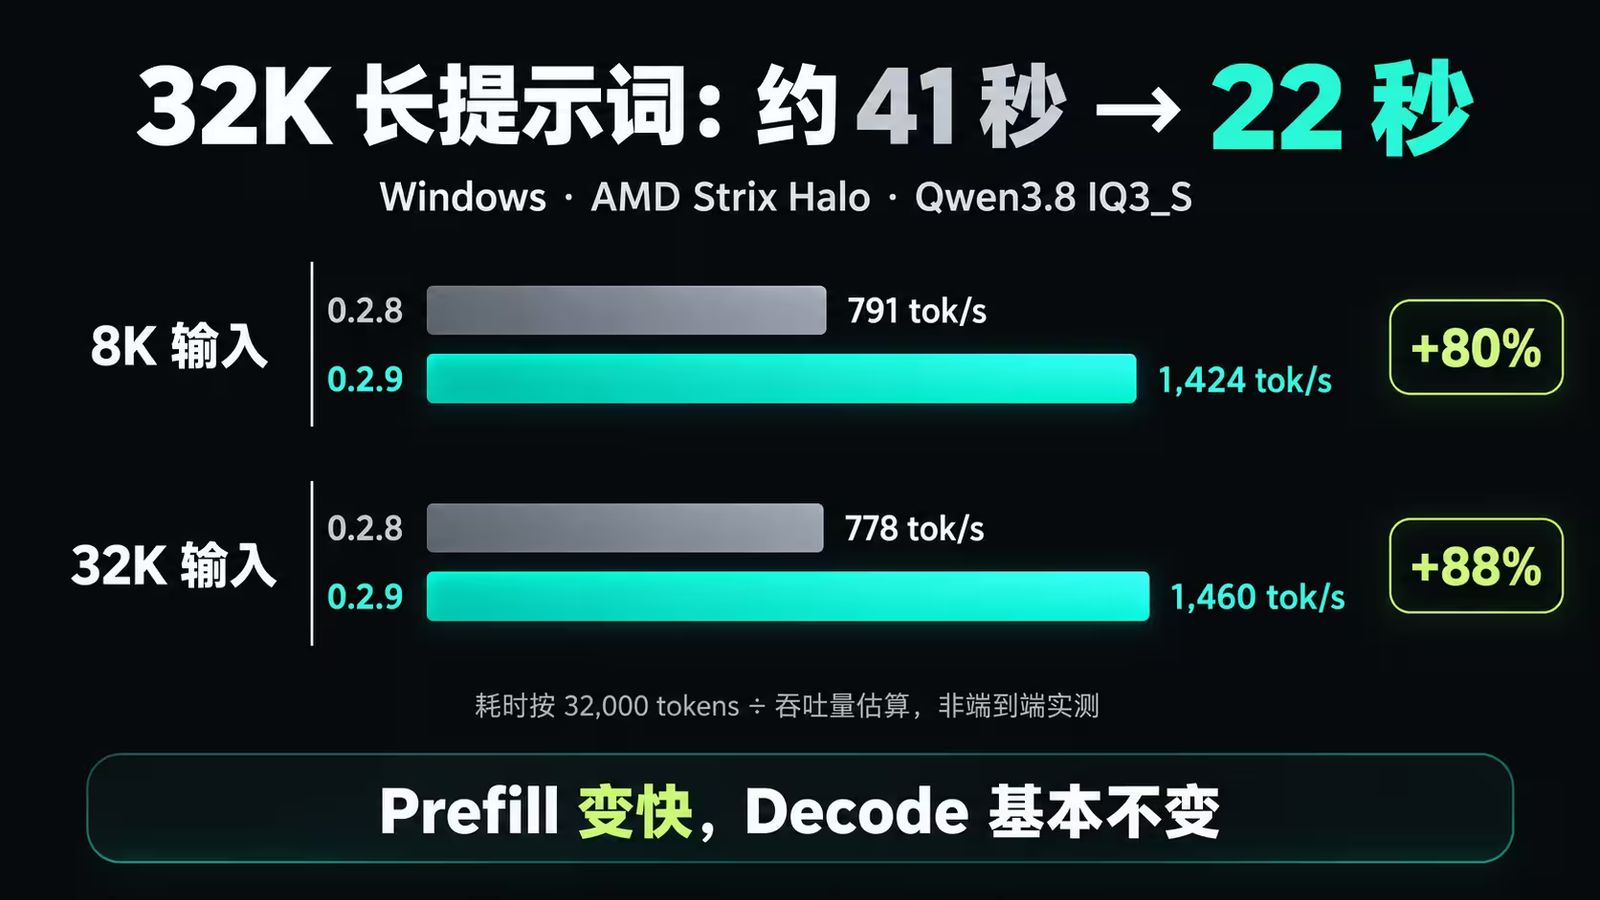
prefill 提速的实际意义,是把你把长文档或几万行代码交给模型后,等它开口的时间变短。按开发者公布的测试:约 3.2 万 token 的输入,处理速度从 778 tok/s 提到 1460 tok/s,粗算等待从约 41 秒缩到约 22 秒;8K 输入提升 80%;但生成回答的解码速度只从 57.4 涨到 58.9 tok/s,官方自己也说这幅度在正常波动内 。
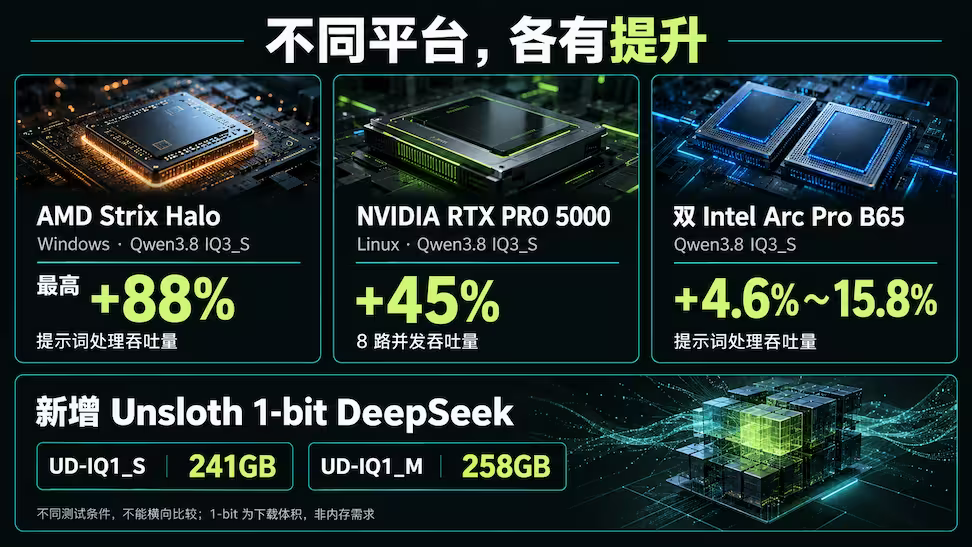
这 88% 的条件很具体:同一台 Strix Halo 电脑、同一个 Qwen3.8 IQ3_S 模型、新旧版本交错跑,没有第三方复测 。其他硬件提升小得多:Linux 上单张 RTX PRO 5000 单请求约 +5.3%、8 路并发约 +45%,两张 Intel Arc Pro B65 约 +4.6%~15.8%,而通过批处理服务器处理单个请求的解码反而慢了约 2.7% 。官方还注明,Strix Halo 新启用的分块评分为非逐位精确,在约 5K 以上提示词时,约 2051 个单元里有 10 个会在临界点翻转 。
1 比特 DeepSeek 分 UD-IQ1_S、UD-IQ1_M 两个版本,下载体积 241GB、258GB——减少的是磁盘占用,并没有变成小文件。官方 61 项任务测试中,两者都完成 53 项,低于 2.25 比特版的 56 项,而且这是厂商单次自测 。
需要留意的是,Strata 更新很快:0.2.10 已在 11 月 3 日发布,改为默认使用 DFlash2,降低显存占用,8GB 显卡也能开 128K 上下文 。想试的人直接装新版更划算;只是不要急着把“快 88%”当成自己机器上也能得到的效果。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] Strata 0.2.9 发布:本地大模型 Prefill 最高提速 88%,还支持 1 比特 DeepSeek
- [S2] Releases · Niko1221/Strata
- [S3] GitHub - Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware: one-click install for Windows / Linux. Strata inference engine, OpenAI/Anthropic API on localhost, optional image input.
- 配图 1:来源:小众软件(图片署名见原文) · 图片出处
- 配图 2:来源:小众软件(图片署名见原文) · 图片出处
- 配图 3:来源:小众软件(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。