
谷歌教 AI 读化学,英伟达教 AI 开工厂:先被吃掉的,是"等结果"的时间
作者:陈一帆
同一天发布的两篇博文,指向同一件事:AI 正在压缩科研与制造流程里最磨人的等待。谷歌给 Antigravity 装上化学信息学技能,一小时走完过去数天的分子分析;英伟达把晶圆厂的工程仿真从数天压到分钟甚至毫秒。但省下的只是等待,不是验证——候选分子仍要合成,良率仍要上产线。
文|陈一帆
11 月 3 日,谷歌 DeepMind 和英伟达各发了一篇博文,主题看着毫无关系:前者给智能体工具 Google Antigravity 装上"化学信息学技能",让它自己读论文、读专利、设计分子 ;后者宣布晶圆厂进入"AI 定义工厂"阶段,用加速仿真、学习型物理模型和数字孪生压缩工程师的决策时间 。把两条放在一起看,它们动的是同一处:提交任务、等结果,然后再决定下一步的那段时间。
"化学信息学"到底在忙什么
先用一个日常场景解释这个词。同一个分子,在论文里是一长串 IUPAC 学名,在专利里画成一张马库什通式图,在试剂目录里又变成一个 SDF 结构文件——就像同一个人的身份证名、小名和证件照,系统得认出这是同一个人。而且这里比认人严得多:改动一个原子或一根化学键,描述的就是另一种化合物,一个本来有效的抑制剂可能就此变成惰性物质 。几十年来,化学家很大一部分时间花在这种"对名字、清数据"上。
谷歌的分工方案说起来朴素:语言模型负责规划、检索文献和化学推理,RDKit 这类确定性工具负责老老实实算分子,再通过连接器接入 ChEMBL 和 PubChem 两个公共数据库 。模型不做算术,工具不做判断,两边各管一段。
一小时的演示,走的是一段已知的老路
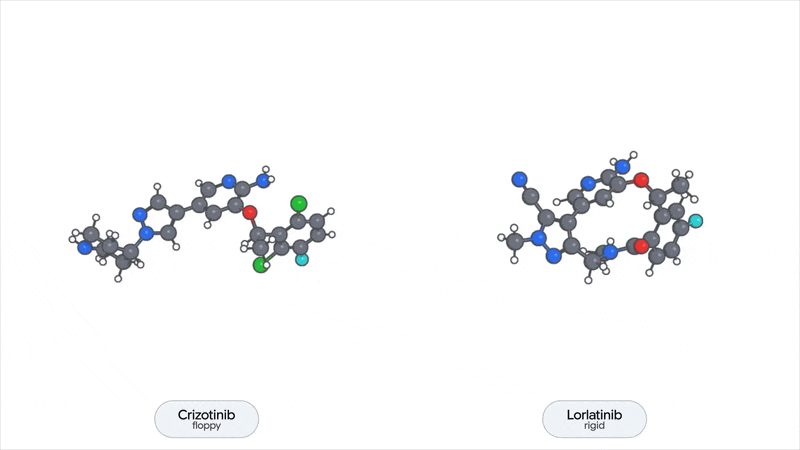
演示选的是一段真实的药物化学史:第一代靶向药克唑替尼有 5 个可旋转键,分子在溶液里能扭成很多形状,"软"得浪费结合时的熵代价;第三代劳拉替尼在末端做了环化,把可旋转键降到零,药效明显提升。这套"把分子加固"的手艺,业内叫刚性化 。
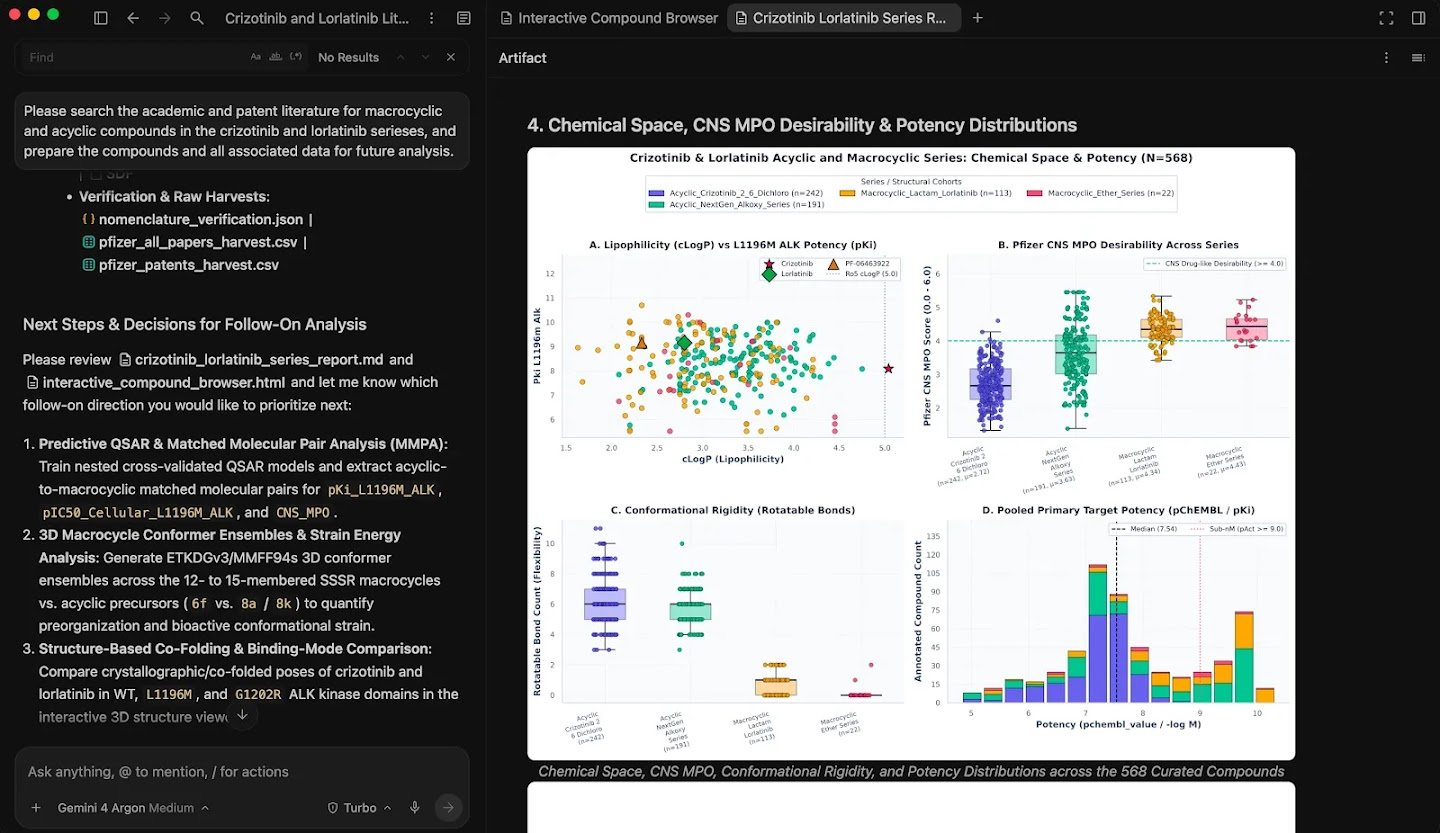
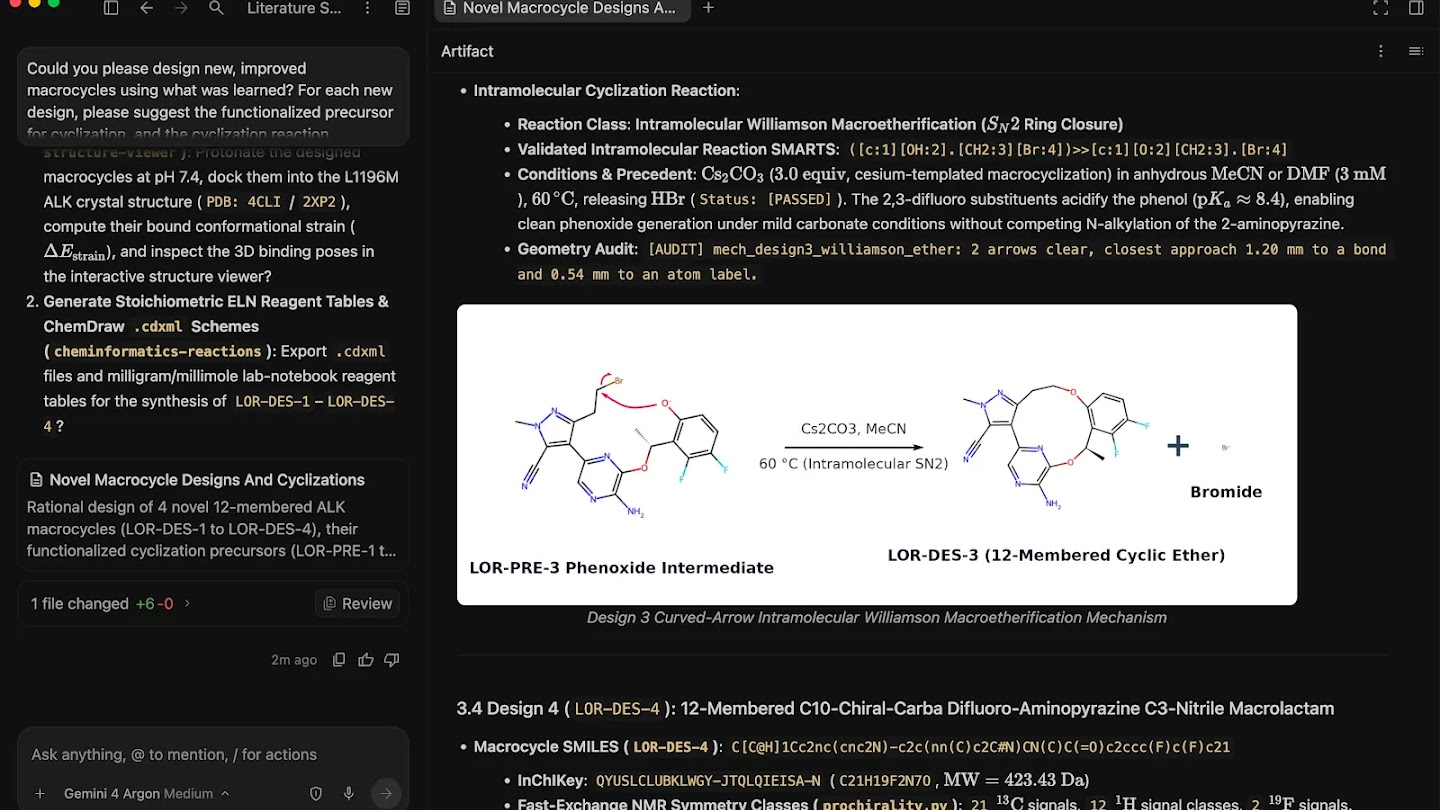
智能体几分钟内就从文献里捞出数千个化合物,先滤掉缓冲液、溶剂这类无关项,还顺手给出一个有用的观察:大环化合物大多被预测为可透过血脑屏障——对经常发生脑转移的肺癌来说,这不是小事。接着它做匹配分子对分析,也就是只挑出"仅差一处改动"的分子成对比较,把这一处改动的效果单独拎出来,逻辑上类似控制变量。再往下是训练药效预测模型、比较多种架构与特征组合,最后提出多个新的大环分子,附上机理的电子推动箭头图和合成路线。整趟下来约一小时,而原文说类似流程过去通常要数天 。
有一点得说清楚:这条路线是从已知药物出发,相当于让 AI 重走一遍有标准答案的老路来证明能力,还不是参与在研的新药项目。
晶圆厂那边慢的不是数据,是物理
英伟达这篇讲的技术分成四层。加速仿真,是把原本跑在 CPU 上的工程仿真搬到 GPU 上;学习型物理模型,是从高精度仿真、实验和产线数据里学温度、压力、等离子体这些变量之间的关系,以后不必每次跑完整计算;AI 智能体,接掉决策之间那些琐碎步骤;数字孪生,把整座厂在虚拟环境里先跑一遍 。
对应到具体数字,都是厂商给的"最高"值:COMSOL 借 cuDSS 把多物理场仿真提速最高 10 倍;西门子把 cuLitho 集成进 Calibre 光刻软件,关键负载最高 17 倍,原文还补了一句——这类计算在 CPU 上按生产规模根本跑不完,加速不只是快一点,是把原本做不了的事变成能做 ;应用材料的 Ginestra 平台对比纯 CPU 方案最高快 10 倍,ACE+ 多物理场平台的形貌仿真在 PhysicsNeMo 加持下最高 35 倍 。Lam Research 的例子更直观:蚀刻用的等离子体行为,完整仿真要数天,PhysicsNeMo 能在毫秒级给出预测 。
作用也不止于"快"。工程师原本要依次跑仿真、看结果、比方案,有时还要排真实试验,一次等上几天,根本没法广泛探索备选方案。现在可以先把明显不行的方案筛掉,把真实产线和完整仿真留给少数关键验证 。
拼起来看:瓶颈从"算不动"挪到了"等不起"
两条线用同一套机制:模型管"想"和"找",确定性工具和物理模型管"算",拍板的仍然是人 。不同的只是对手——谷歌对付数据的乱,把散落在论文、专利、目录里的同一个分子认齐;英伟达对付计算的慢,把天级仿真变成分钟级预览。省下来的等待流向同一个地方:更早试更多方案,更早发现风险。
哪些已经能用,哪些还只是说法
这笔账要分开记。已经落地的:这套化学信息学技能今天就能用,装 Antigravity 应用再装 Science 插件即可,企业用户用 Google Cloud 账号登录;另有最多 1 万名科学家可获 6 个月最高用量档免费,但要符合资格、受容量限制、滚动录取,不是人人有份 。还停在说法层面的:英伟达文中数字全部来自合作厂商自述,措辞统一是"最高",ACE+ 那个 35 倍的对比基准原文没有写明,只有 Ginestra 的 10 倍明确写了对比纯 CPU 方案 ;至于"AI 定义工厂"的完整闭环——产线数据喂模型、模型反过来支撑决策——原文写的是"that's the promise",是愿景,不是已交付的清单 。
也别高估分子这一侧的提速。谷歌自己强调,产出是可检验的科研假设而非成品药;数据稀疏、实验室之间的检测误差、窄动态范围都会限制预测精度,每个候选分子仍必须合成并做实验验证 。还有一处口径分歧值得一提:IT之家报道说演示检索并整理了 568 个化合物,这个数字在谷歌原文全文里没有出现,原文只说检索到数千个化合物再作过滤 。遇到这种细节,我更愿意按原文来理解量级。
一句话总结:AI 先吃掉的是等待,不是验证。等待缩短这件事已经发生了;药效会不会变好、良率会不会提高,还得看实验台上和产线上的那一步。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] 提速抗癌药物研发:谷歌 Antigravity 上线“AI 炼丹师”,1 小时筛完数千种化合物
- [S2] 英伟达称 AI 重塑芯片工厂:仿真提速最高 35 倍,工程师决策从数天缩至数分钟
- [S3] Agentic cheminformatics with Google Antigravity
- [S4] AI Is Changing How Semiconductor Fabs Work — and Engineers Are Moving Faster Because of It
- 配图 1:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 2:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 3:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 4:来源:www.ithome.com(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。