
32MB 就能生成语音和音乐?先把「小」这件事算清楚
作者:陈一帆
X 上流传的「Underdog 32MB 模型同时生成语音与音乐」目前只有一句社媒断言,找不到原始公告或 demo。而同期 arXiv 上的《BitNet Text Embeddings》确实展示了把 2.7 亿参数模型压到几十 MB 量级的路径——只不过它做的是文本嵌入,不是出声。把两条线分开看,才能看清端侧小模型现在到哪一步了。
11 月 8 日,X 上一个聚合账号发了条帖子:Underdog 的 32MB 小模型,能轻松生成高质量语音和音乐,还带了一句「Impressive」和一个短链接 。这条被转了不少次。
我去找原始出处,结果很干净:没有公司页面,没有项目仓库,没有可试听的 demo,也没有技术公告。整条消息就是一句断言 。所以「32MB 同时生成语音和音乐」现在只能算社媒传闻——它可能是真的,也可能只是把几件事揉在了一起,但目前没有材料能证实任何一头。连「Underdog」是公司、项目还是模型名,都说不清。
不过这条传闻搭上的是一条真实存在的技术线。今年 6 月提交、7 月更新到 v2 的 arXiv 论文《BitNet Text Embeddings》(简称 BitEmbed),做的就是把这类的预训练模型压成「三值权重」的编码器,实验用的两个骨干之一正是 Gemma3-270M ,2.7 亿参数级别的小家伙。但要说清楚:这篇论文做的是文本嵌入,服务检索、RAG、推荐和问答,全文不涉及语音或音乐生成 。它能解释「几十 MB 装一个模型」怎么做到,不能解释「32MB 出声」。
32MB 是什么概念
一首四分钟、320kbps 的 MP3 大约 9MB。32MB 差不多是一首无损歌,或者手机相册里二十来张照片。放在今天的应用生态里,这个体积小到几乎不占地方。
再看参数换算。2.7 亿参数按 fp16 存,每个参数 2 字节,约 540MB,这是估算。换成 BitNet 式的三值权重,理论上每个权重 1.58 比特,光权重部分就落到 50MB 上下;再加上缩放因子、归一化层和词表,整体落在几十 MB 量级,算术上讲得通(以上为估算,非论文实测数字)。
所以「32MB 装下一个 2.7 亿参数的模型」不离谱。但前提是——它是嵌入器,不是生成器。
省下来的空间从哪来
论文里的做法可以拆成几件事 。
第一,权重只留三个值。每个权重被映射到负 Δ、0、正 Δ 三档,Δ 按整层权重的平均绝对值算。这就是所谓 1.58 比特——三档信息量是 log₂3。
第二,激活值按 token 做 8 比特量化,不是全精度。
第三,每层插一个子层归一化(SubLN),把进入量化投影的输入拉到比较一致的尺度。量化越狠,模型对数值噪声越敏感,这一步是用来稳住训练的。
第四,量化里的四舍五入不可导,用直通估计器近似梯度,反向传播才能走通。
训练也分三段:先把预训练骨干转成三值编码器;再用大规模文本对做对比持续预训练,把被量化压坏的语义空间重新撑起来;最后做带蒸馏的监督微调——教师是一个 fp16 全精度嵌入模型,学生不只要学会「谁跟谁像」,还要对齐教师的相似度分布和注意力关系 。
有个细节挺值得做产品的人留意:输出向量支持多精度。同一个权重包,可以按不同存储预算吐出不同精度的向量,不用为每种预算各训一个模型 。对大索引来说,这比模型本身省了多少更实用。
便宜是有代价的
论文自己写得很直白:极端量化会扭曲预训练已经学到的表示空间,光靠监督微调的数据量,不足以让模型重建可靠的语义表示 。所以才要补一大段持续对比预训练。
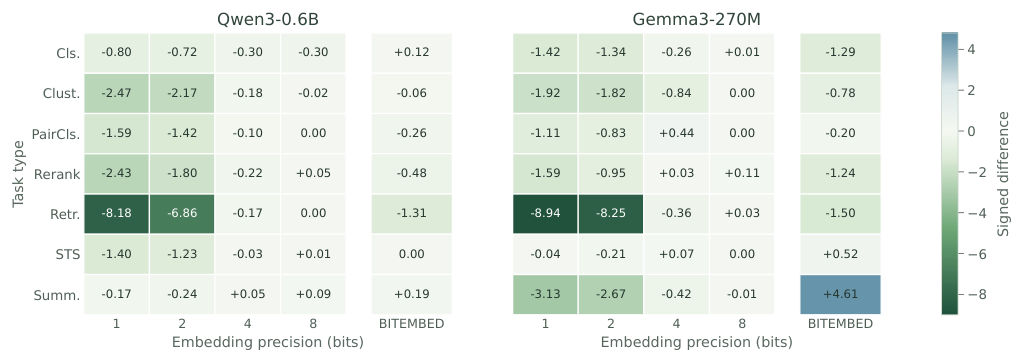
结论的措辞也值得读两遍:在 MMTEB(eng, v2) 上,BitEmbed「大体可比」全精度教师(largely comparable)。不是超过,也不是等于。至于具体掉多少分、不同精度档位各差多少,我读到的文本停在方法章节,实验表格没拿到,这里就不给数字了。
另外,Gemma 3 的技术报告里,这个家族写的规模是 10 亿到 270 亿参数 ,270M 版本不在报告覆盖范围内,它的具体规格我只能从论文里的模型名推断,没有一手材料核对。
手机上真正先落地的会是什么
想象一个场景:你在飞机上,想找三个月前自己在备忘录里记的那句「房东说押金月底退」。手机没有网,但本地存了几千条备忘和几万条聊天记录。如果手机上跑着一个几十 MB 的嵌入模型,它不需要生成任何一个字,只要把这些文本变成向量,算出哪几条最接近你的问法。这类能力已经有了论文支撑的技术路径 ,而且全程不用把内容传出去。
语音和音乐就是另一码事了。要出声,得有解码器,要有声码器把中间表示变成波形,还要采样、拼接、控制时长。这些模块不是把权重从 16 位砍到 1.58 位就能一起消失的。32MB 里塞下一个能离线生成语音的完整包,目前没有任何证据支持。
所以我把这条传闻分成两栏。左边一栏写「已实现」:几十 MB 量级的小模型可以做文本语义表示,检索、本地搜索、离线找聊天记录,这条路有论文、有方法、有公开的模型地址(论文自述托管在 Hugging Face,这个页面我没能打开核验)。右边一栏写「期待」:32MB 直接在手机上生成语音和音乐。等真有人放出可试听的 demo 和原始公告,再把它挪到左边不迟。
传闻当路标看是好的,它指向了一个确实在发生的方向:模型在变小,而且不是靠砍功能变小,是靠重新设计数值表示变小。但当路况看就不行了。这两件事之间,差着一整篇论文的距离。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] Underdog’s tiny 32MB AI model is a game-changer, capable of generating both high-quality speech and music with ease. Imp · Pingnednews
- [S2] arXiv Query: search_query=all:"Gemma3-270M"&id_list=&start=0&max_results=20
- [S3] BitNet Text Embeddings
- [S4] BitNet Text Embeddings
- [S5] Gemma 3 Technical Report
- 配图 1:来源:arxiv.org(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。