
LLM 只清训练标签、不进上线模型:EEG 睡眠分期准确率提 2.8 个百分点
作者:许棠
一篇 arXiv 论文用 LLaMA 3.1 在训练阶段筛掉可疑的睡眠分期标签,重训后总体准确率从 81.8% 升到 84.6%,部署端仍是 130 万参数的小模型。
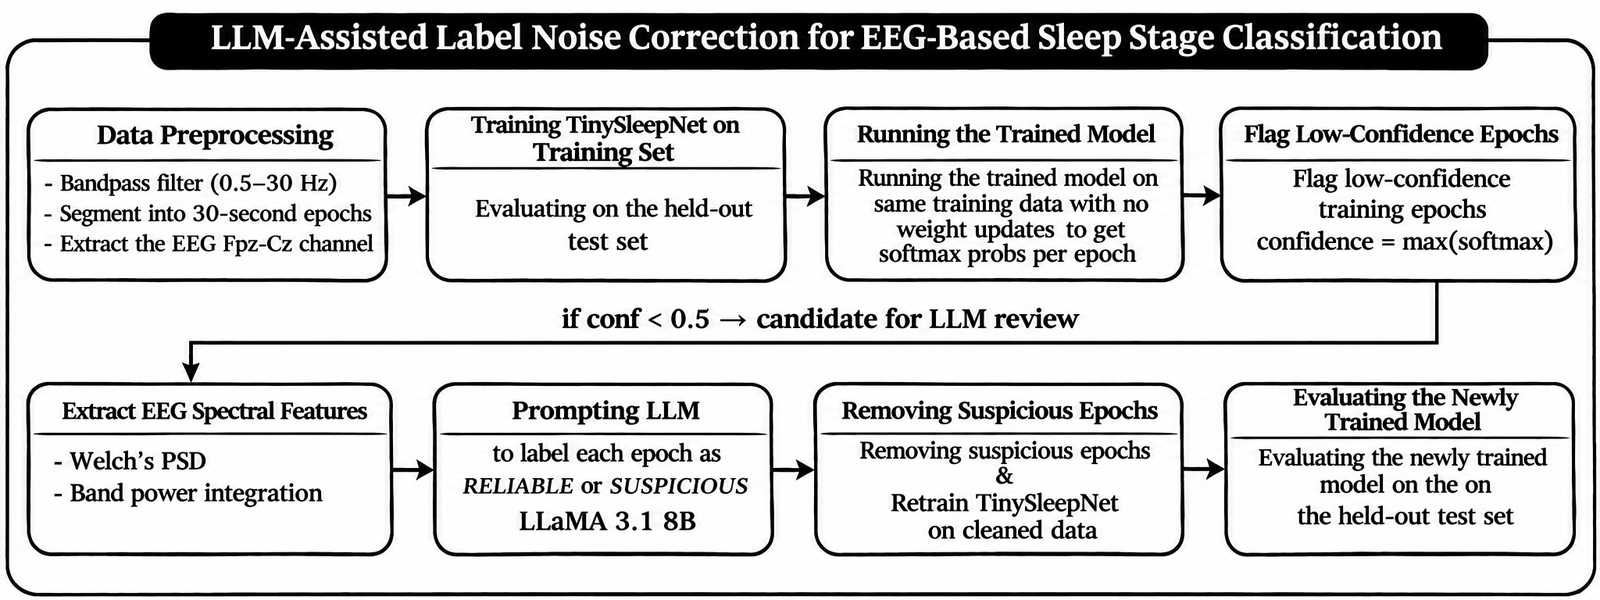
一篇 arXiv 论文把大模型放在训练阶段,专门清理标签噪声:EEG 睡眠分期模型总体准确率从 81.8% 提到 84.6%,Macro F1 从 75.6% 升到 77.4%,而部署端仍是 130 万参数的 TinySleepNet 。
做法不复杂。TinySleepNet 先跑一遍,挑出置信度低于 0.5 的 30 秒脑电片段,把频谱特征、前后片段和模型预测一起交给本地运行的 LLaMA 3.1 8B,按 AASM 睡眠判读标准给出「可靠 / 可疑」的结论;可疑标签删掉,再从头重训 。
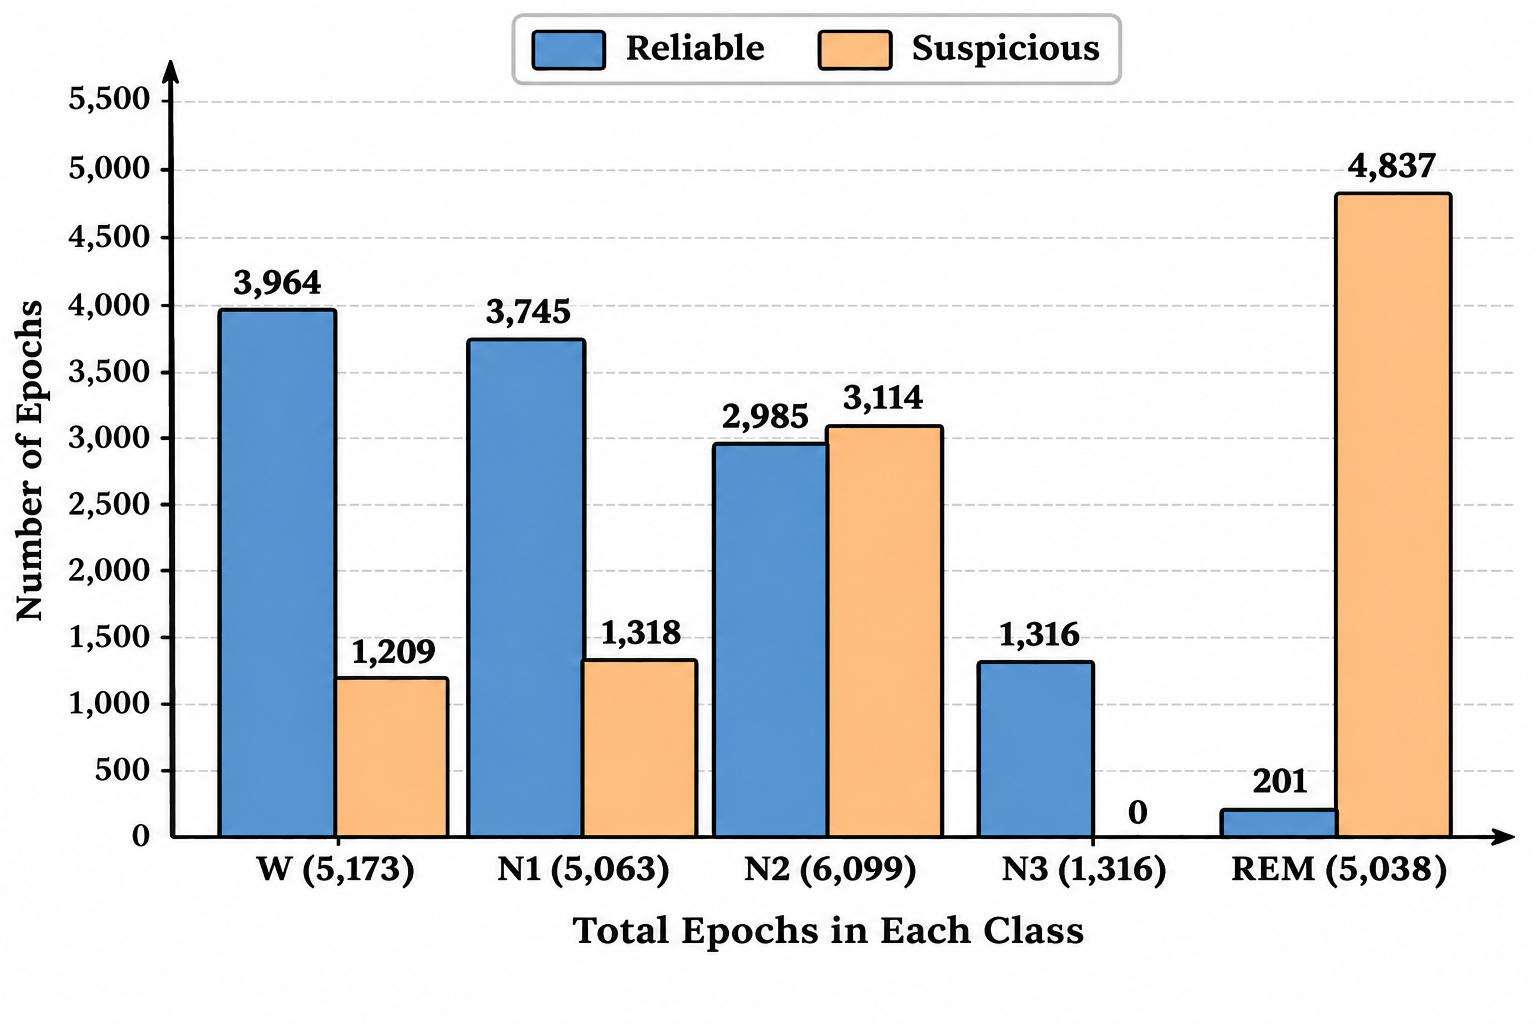
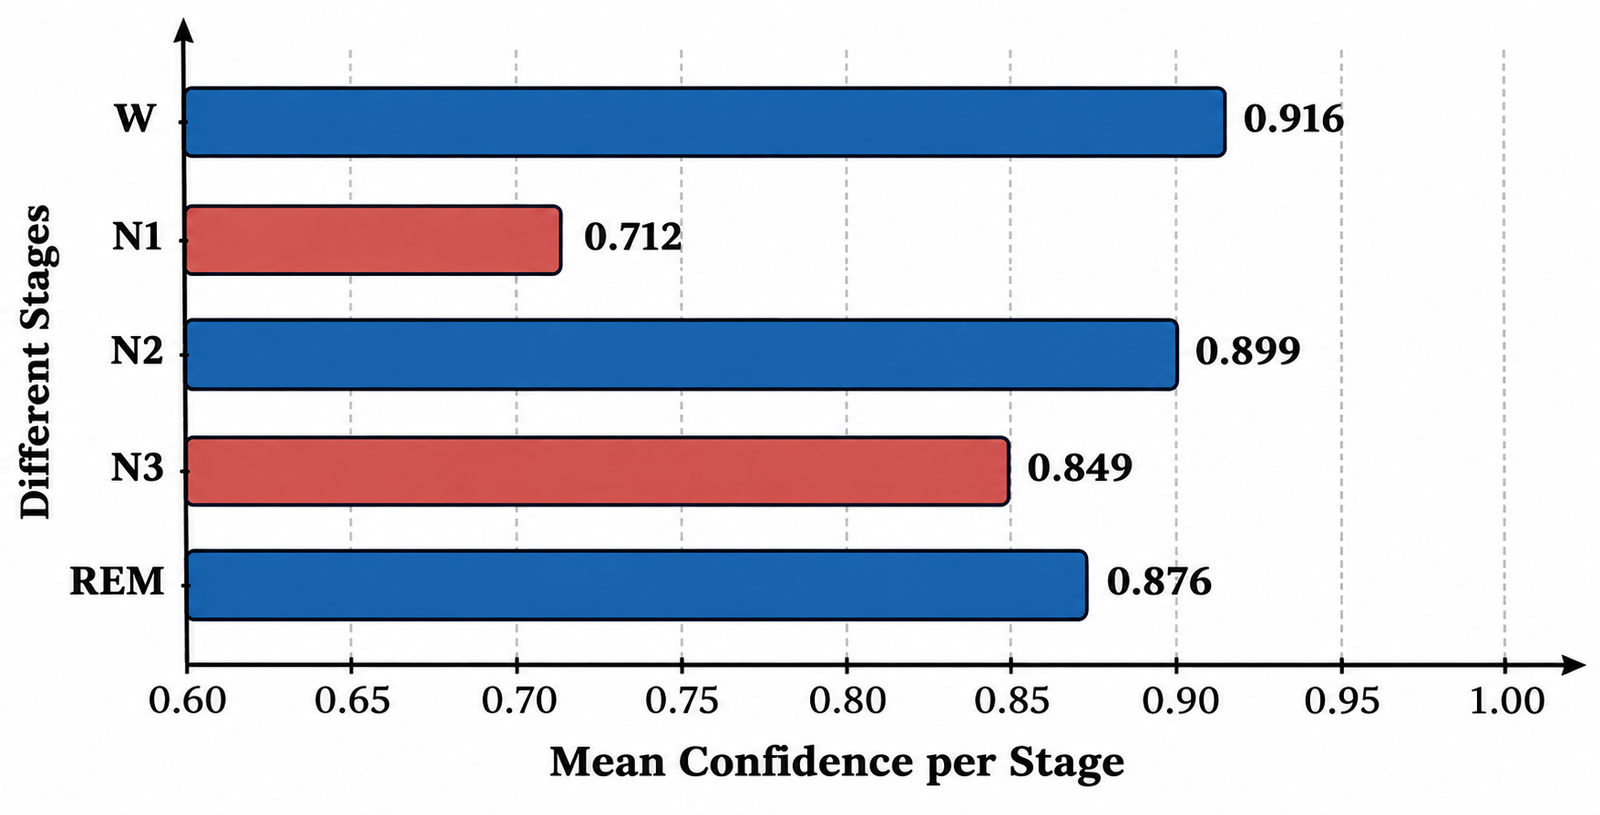
规模上,论文用的是 Sleep-EDF Expanded,78 名健康受试者、153 份记录、单导联 Fpz-Cz,20 折交叉验证;76 万多个训练片段里筛出 22689 个候选,最终删除 10478 个,约占训练数据 1.4% 。对医院的实际意义在于:LLM 只在训练时跑,推理路径不变,不必为这点准确率再买一份大模型算力。论文也拿需要 110 亿参数模型参与推理的同类方案做了对比 。
但先别当成定论。数字是作者自报,只在一个公开数据集上验证;被判「可疑」的 REM 片段占 96%,这些标签是否真错,没有专家金标准复核,论文自己也写明 LLM 的推理需要独立评估 。省下的是部署成本,赌上的是清洗质量——跨数据集和真实标注流程验证之前,这只是一条值得跟进的思路。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] Paper I’m reading today — November 7, 2026 Can an LLM help improve a clinical AI model without becoming part of the mode · Dijkstra Liu
- [S2] LLM-Assisted Label Noise Correction for EEG-Based Sleep Stage Classification
- [S3] LLM-Assisted Label Noise Correction for EEG-Based Sleep Stage Classification
- 配图 1:来源:arxiv.org(图片署名见原文) · 图片出处
- 配图 2:来源:arxiv.org(图片署名见原文) · 图片出处
- 配图 3:来源:arxiv.org(图片署名见原文) · 图片出处
0
评论 0
还没有评论,来抢沙发。