
GitHub 内测新存储架构 Rubicon:单仓库支持 5000 个智能体、每秒处理 7200 次推送
作者:陈一帆
GitHub 在 Universe 大会上公布的新一代 Git 存储架构定名 Rubicon。官方称,内部压力测试中单个仓库可支持 5000 个智能体并发协作、每秒处理 7200 次推送,读取可按需水平扩展。定向内测已开启,计划明年初扩大范围;不过这些数字仍属厂商内部测试结论,费用与配额尚未公布。
11 月 5 日,GitHub 发布博文,把上周在 GitHub Universe 大会上公布的新一代 Git 存储架构正式定名为 Rubicon。官方称,内部压力测试中,单个代码仓库能支持 5000 个智能体(Agent)并发协作、每秒处理 7200 次推送,读取还能按需水平扩展。这项能力目前仍处于小范围定向内测(limited private preview)阶段,计划明年初逐步扩大开放。
老仓库被压垮的原因
可以把一个代码仓库想象成小区公告栏:以前是十几个人贴通知,每天贴几张,贴完就走。现在换成一屋子不下班的机器人,全天轮着贴。
按 GitHub 给出的数据,如今最繁忙的仓库单秒写入峰值也不过几十次,而且是脉冲式的:忙一下,停一阵。原因是人写代码有节奏:想清楚、写、等评审、睡觉。全天候运行的智能体没有这种节奏,于是间歇出现的高峰正在被拉成持续的高吞吐。
代价更高的是随后的连锁反应。一次 push 不只是改了若干文件:CI 流水线立刻启动,部署系统来拉取最新提交,其他智能体也会把代码读进自己的上下文当参考。写一次、读几十次,官方称之为读扇出(read fan-out)。仓库越热闹,读请求被放大的倍数就越高。
大量智能体挤进同一个仓库,还会带来另一层摩擦:多个分支和引用(refs)在相近时间被改写,合并冲突和重试变多,CI 又被来回触发。这一层是我按 Git 的常规工作方式做的补充解释;GitHub 博文强调的主要是读扇出对整体流量的放大。
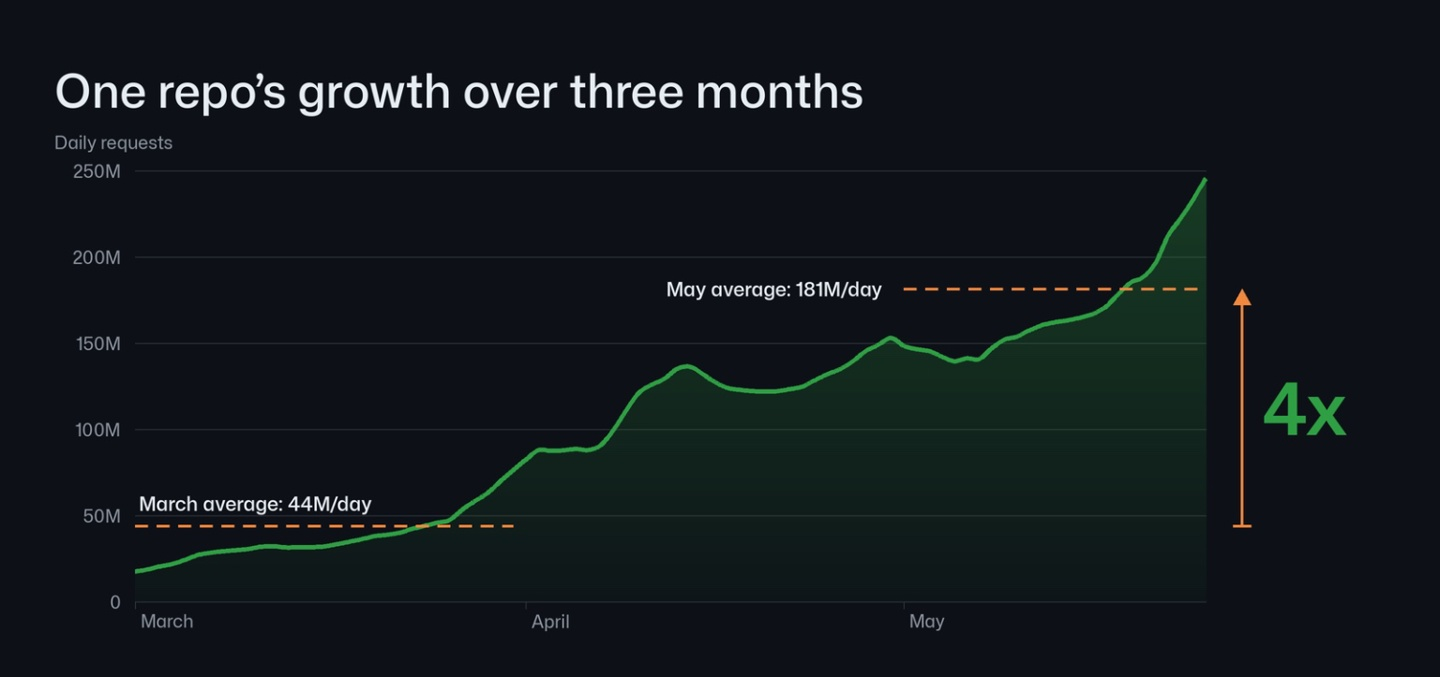
趋势已经露头。博文举的例子是某个头部仓库:3 月到 5 月,日请求量涨了约 4 倍,此后仍维持着很陡的上升曲线。
新架构的两个方向
按官方描述,Rubicon 的应对分为写入和读取两条路径。写入侧设计成每秒能处理数千次操作;读取侧按需水平扩展,也就是读不过来就增加机器,不让所有请求排队等同一套存储。压测中能支持 5000 个智能体、每秒 7200 次推送,同时读取延迟保持很低,这是两条路径共同作用的结果。
至于 refs 具体如何修改、与老 Git 协议如何兼容、迁移怎么实施,公开转述里都没有提到,而这些恰恰是工程上最费劲的部分。
边界要划清楚
这几个数字全部来自 GitHub 自己的内部压力测试,属于厂商声称;压测负载如何构造、其中混入了多少真实仓库流量,外部看不到。我目前读到的实质报道只有 IT之家的一篇转述,官方博文原文的措辞仍有待核对。内测采用定向邀请,费用和配额也没有公布。
所以准确的说法是「GitHub 证明了自己能做到」,而不是「你现在就能用上」。
对团队来说,真正值得关注的是明年初的开放节奏。如果你的仓库天天 CI 排队、几个智能体一开就互相冲突,那才是检验这套架构的时候:自家最热闹的那个仓库,比任何压测数字都更能说明问题。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] GitHub 推出新 Git 存储架构:内部测试单个代码仓库支持 5000 个智能体同时协作,每秒处理 7200 次推送
- [S2] Home
- [S3] Company news Archives
- 配图 1:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 2:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 3:来源:The GitHub Blog(图片署名见原文) · 图片出处
- 配图 4:来源:The GitHub Blog(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。