
METR 在 Anthropic 驻场 11 周:模型改进速度约为一年前两倍,关键证据被删减
作者:陈一帆
METR 上周四发布评估报告:Anthropic 的模型改进速度约为一年前的两倍,一年走完历史上约两年的进步;加速主要归因于 AI 辅助人类研究员,而非单纯增加算力。但 METR 约 100 页的完整报告,公开版中大部分关键证据被 Anthropic 删减,安全研究者同时质疑透明度与实际风险。
METR 上周四发布一份评估报告:研究者在 Anthropic 内部驻场 11 周,评估这家公司究竟如何“用 AI 做 AI 研发”。结论是,Anthropic 模型目前的改进速度约为一年前的两倍,基准分数显示它一年走完了历史上大约两年的进步量,而且看不到明显放缓迹象 。
这里的“两倍”指的是同一套基准上的进步速率对比,不是产品版本号翻倍:过去 12 个月的分数涨幅,相当于此前要 24 个月才拿到的涨幅 。METR 说,他们有信心这部分加速不只是增加训练算力换来的——历史上算力扩张一直是主要驱动因素——截至今年 10 月,加速的大部分“归因于 AI”,这个占比还在上升 。
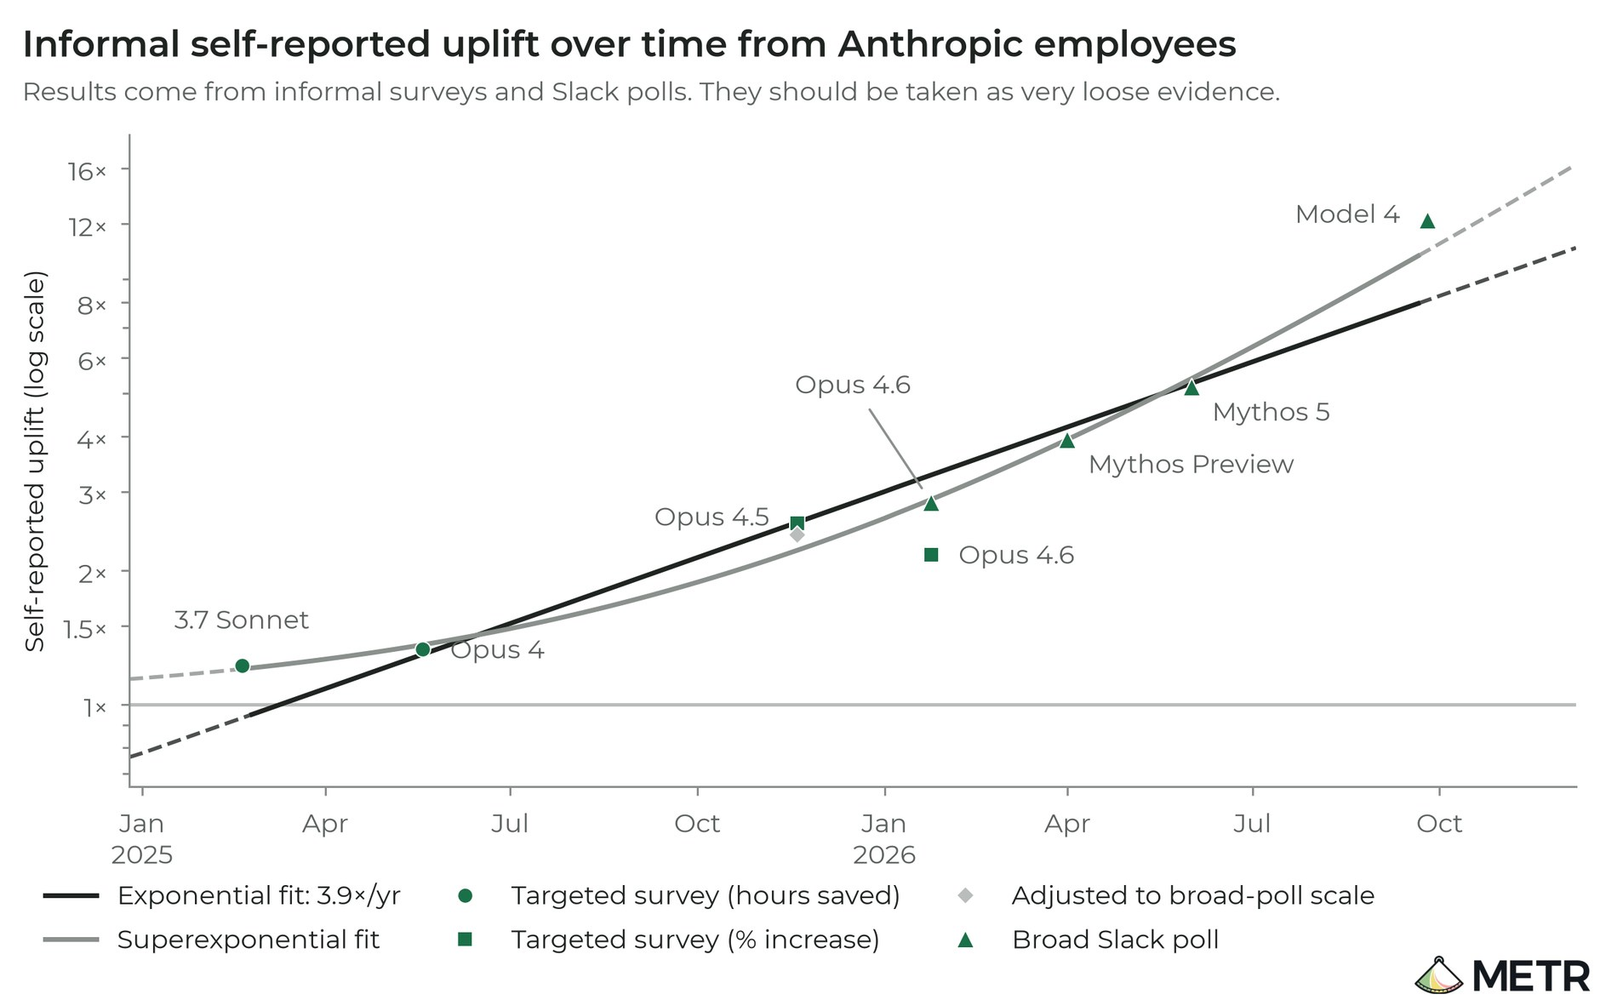
那具体是哪些环节?公开版没有给出完整清单。METR 能说的是:目前大部分加速来自 AI 辅助人类研究员,而非 AI 独立做研究;另外“有一些迹象显示,完全自主的贡献很快会扮演更大角色” 。依据有三类:基准分数、内部 Slack 上的非正式投票、员工访谈。用上最强内部模型的员工自报效率约是自己动手时的 12 倍,大约是几个月前用 Mythos 5 时的两倍 。注意是“自报”,不是掐表计时。
还有一个细节:过去半年 Anthropic 训练完三个尚未发布的模型,代号 Model 2、3、4,分别在 7 月、8–9 月、9–10 月完成;METR 还提到一个 2022 年的未发布模型 。外界能用的模型与内部在用的模型之间,隔着几代。
“反馈环”是什么感觉?可以想成一个学生自己出题、自己判卷,再按判卷结果决定下一本教材写什么。出题和批改都不用等人,每轮自然更快。风险也在这里:判卷标准本身有偏差时,错误会被当成正确答案写进下一轮,而且越滚越大。METR 给出的是速度证据,不是终点;现在是人和 AI 配合的快,全自动那一步尚属“有迹象” 。
安全圈的反应分两层。一层是修正预期:METR 研究员 Ryan Greenblatt 称自己此前“严重低估了 RSI(递归自我改进)的加速,原以为 2026 年不会有这么多” ;GovAI 的 Alan Chan 认为,怀疑者应缩短“软件工程任务被完全自动化”的时间预期 ;Apollo Research 的 Marius Hobbhahn 说,这一进度比《AI 2027》的推演还略快,并留下一句“准备好迎接疯狂” 。
另一层是质疑流程。争议主要涉及透明度,数据本身并不是重点:METR 向 Anthropic 提交了约 100 页的完整评估,公开版中“我们找到的最有信息量的多数证据”被删减 。METR 说,这使得公众只能更多依赖它的判断,无法自己核对 。Anthropic 联合创始人 Sam McCandlish 承认,删减“让外界更难检验 METR 的工作”;但他认为,公开究竟是什么在推动加速“既涉商业敏感,也等于给同行发一份提速路线图”,会让 METR 担心的风险变得更糟 。Anthropic 没有回答 The Verge 的提问,只是把记者引向这篇回应 。
还有一项被取消的核查:原本要评估公司把多少算力投向安全、多少投向能力提升,Anthropic 表示希望这次合作先聚焦风险评估,算力分配核查以后再谈 。前 OpenAI 研究员 Daniel Kokotajlo 的批评更直接:一家“看起来根本没怎么减速”的公司,拿别人会加速当删节理由,相当讽刺 。政策层面也有动作,纽约州众议员 Alex Bores 呼吁国会“今年就禁止 RSI” 。
要核对的部分与待核对的部分得分开。已经核对的是:加速被测量到了,形态主要是辅助人。待核对的是“两倍”的精确测量方式:基准怎么选、和历史曲线怎么对齐、有没有把算力与算法改进的影响分开计算。这要看 METR 的未删节版本。报告也只覆盖 Anthropic 一家;OpenAI 9 月称正朝“2028 年 3 月前建成能推进深度学习与对齐研究的 AI 研究员”取得进展 ,那是目标,不是结果。对日常用产品的人来说,这次变化暂时还看不见,主角全是内部模型。真正值得关注的只有两件事:METR 后续能否拿到更完整的数据,以及 Anthropic 承诺几周内自己发布的那份进展与安全报告 会不会给出可验证的细节。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
评论 0
还没有评论,来抢沙发。