
2100万条序列-结构对喂出的RNA模型structRFM,想解决的是"换个家族就失灵"
作者:陈一帆
深圳湾实验室团队在《自然》发表开源RNA基础模型structRFM,用2100万条序列-结构对预训练,主打二级/三级结构预测与跨家族零样本泛化。它和AlphaFold的区别在于数据形态:RNA实验结构少,只能靠大规模配对数据补课。具体提升幅度与开源范围仍需看论文细节。
文/陈一帆
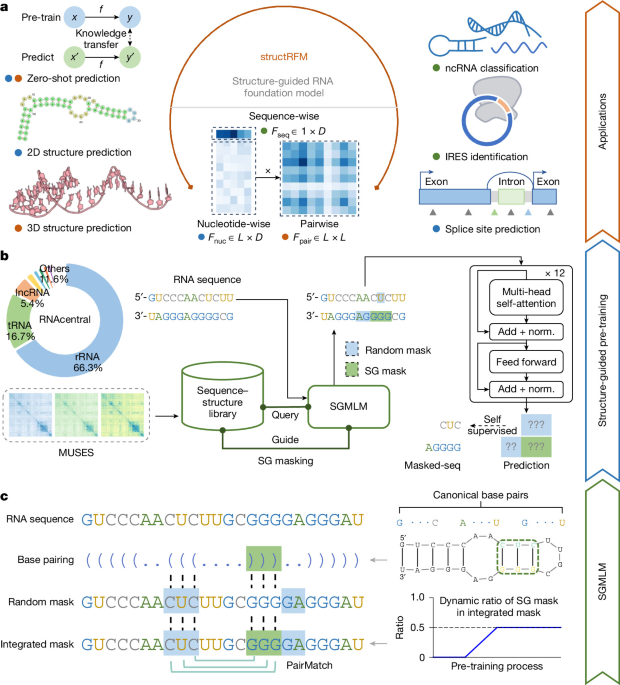
深圳湾实验室系统与物理生物学研究所的团队在《自然》发表了一个名为 structRFM 的 RNA 基础模型,作者署名里能看到 Heqin Zhu、Ruifeng Li 和 S. Kevin Zhou。按论文摘要的说法,它用 2100 万条序列-结构对做预训练,学到多模态表示,改善了 RNA 二级结构、三级结构预测和功能推断,并在多样的 RNA 家族之间表现出零样本泛化。
从工程角度看,变化在数据形态:过去的 RNA 结构预测,多半是拿一条序列去套热力学规则,或者找一个同源模板照着改;structRFM 先把"这串碱基"和"它怎么折叠"成对地喂给一个大模型,让它先建立对应关系,再去接具体任务。
为什么一条 RNA 的"形状"值得花钱算
mRNA 疫苗的序列能不能被核糖体顺利读出来、siRNA 药物能不能精准贴上靶标、环状 RNA 的翻译元件为什么在某些序列上特别活跃——这些都取决于分子折叠成什么三维形状。同一串碱基,折法不同,功能可能完全不同。而实验解析一个 RNA 结构慢、成本高,能拿到实验结构的序列只是极少数,剩下的大批候选分子只能靠计算机预测。预测不准,下游的稳定性设计、剂量选择就得靠反复试。
和 AlphaFold 不是一条路
AlphaFold 的底气来自蛋白质领域几十年攒下的实验结构库,论文参考文献开头就是 AlphaFold 3 与 PDB 相关工作。RNA 没这个家底:CASP、RNA-Puzzles 这类专门评测的存在,本身就说明 RNA 三维预测更难做。所以 structRFM 换的是数据策略,不等实验结构攒够,而是把 2100 万条序列-结构对当教材。打个比方,AlphaFold 像照着几万张成品图学画,structRFM 更像拿着一大摞"零件清单加组装示意"练看图。
这里有个细节要讲清楚:这 2100 万条里的"结构",有多少来自实验解析、多少来自计算衍生,摘要没交代。参考文献里出现 RNAcentral、Rfam、bpRNA 等二级结构数据库,可以当作数据来源的线索,但不能直接当作结论。
零样本泛化是卖点,也是分界线
"零样本"听起来抽象,场景却很具体:你设计了一条全新的 mRNA,训练集里找不到同家族的已知结构做参照。只认训练家族的模型在这里容易掉链子。摘要称 structRFM 能跨多样 RNA 家族零样本工作,这句话的分量得看结果部分:对标哪些方法、覆盖哪些家族、差多少。参考文献里能见到 RiNALMo、DRfold2、UFold、ViennaRNA 这些常见对手,说明比较是在一条成熟赛道上做的;具体提升数字,本文不转述没核到的部分,"更好"目前仍是论文作者的说法。
"open"这个词需要用仓库来兑现
标题里写 open,对国内做核酸药和 AI 制药的团队来说,关键在三个具体问题:代码能不能跑、权重能不能下载、许可证允不允许商用和微调。真实流程很朴素——把自家管线里几十条候选序列丢进去跑一遍,看预测和实验对不对得上,对不上就微调。没有可下载的权重,这一步无从谈起。开源范围与仓库地址目前仍待确认,这也是我判断这条新闻实际价值的最大变量。
我乐观的地方不在它比谁高几个点,而在于这条路线可复用:先让模型理解序列和结构的对应关系,下游任务各自微调。不过边界也要说清:通用预训练不等于每个家族都最强;RNA 在溶液里会变形,静态结构预测本身就是个近似。structRFM 解决的是"有没有一个不用每次从零训练的起点",还没解决"预测等于真相"。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] An open structure-guided RNA foundation model for generalizable prediction
- [S2] structRFM | Nature Search Results
- 配图 1:来源:Nature(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。