
Meta 的 Muse 能“打电话”了:实时语音加会做表情的虚拟形象,先推美国
作者:陈一帆
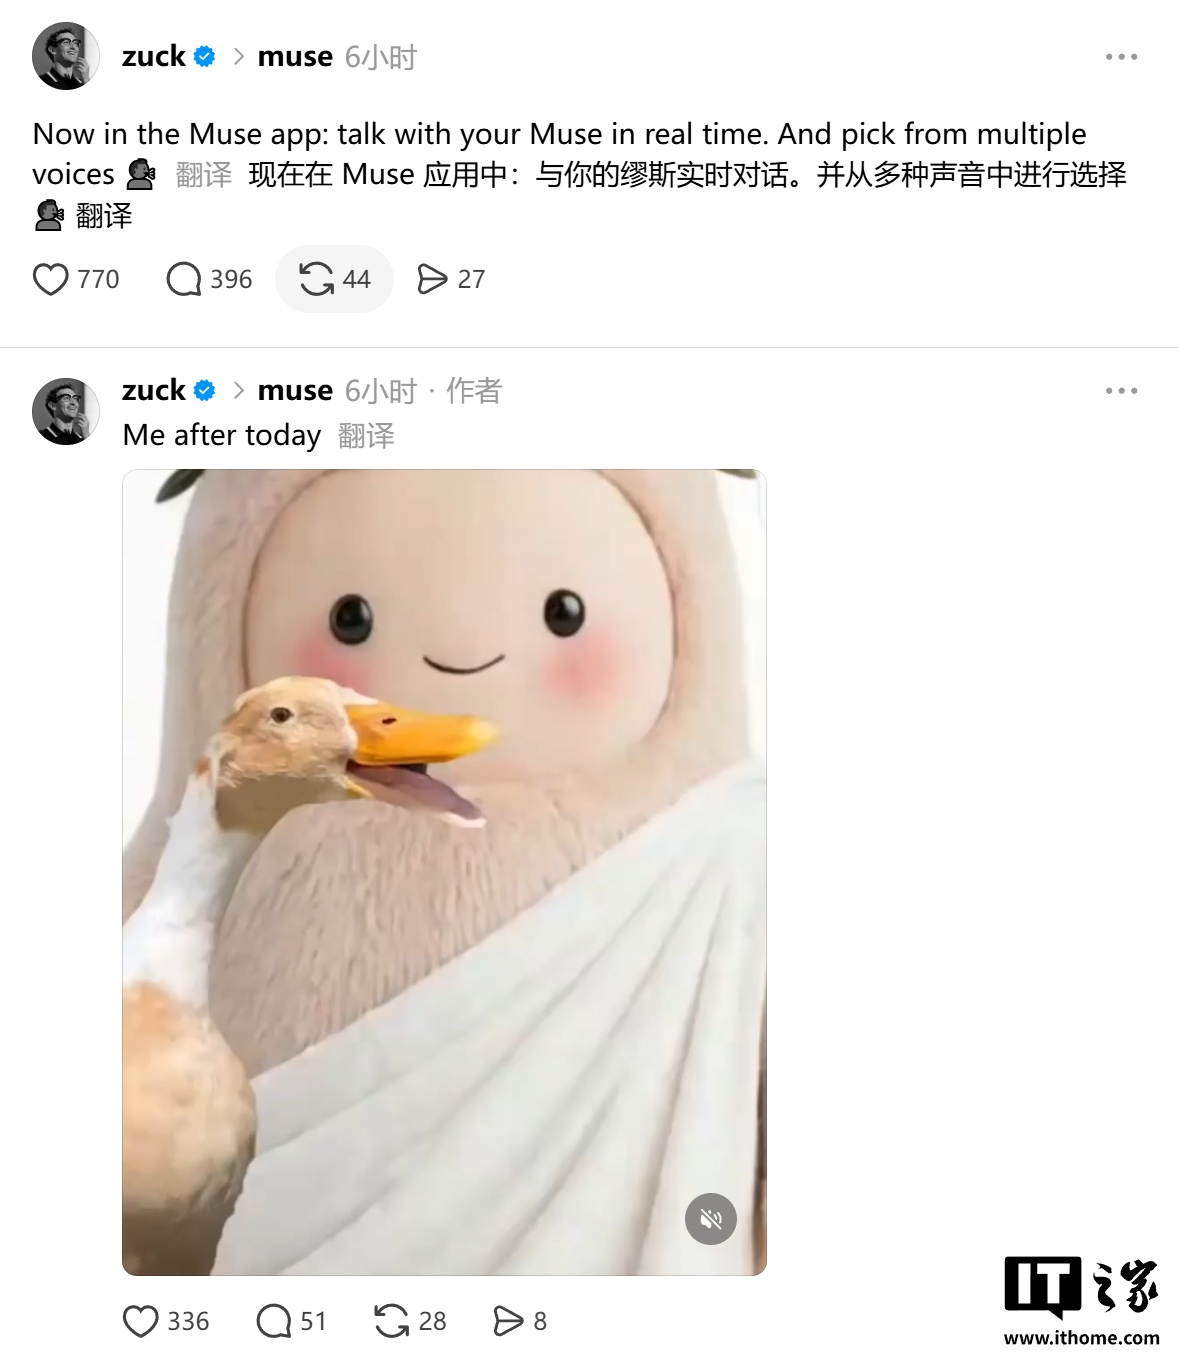
11 月 6 日,扎克伯格在 Threads 宣布 Meta 的个人 AI 助手 Muse 上线实时语音对话与带表情的虚拟形象,美国用户先用到,覆盖移动端、网页和 Mac。点电话图标就能像打电话一样聊,随时能打断;背后是 Muse Realtime Voice 和 Muse Realtime Avatar 两个模型。是否免费、国内能否使用等问题还没有明确答案。
Meta 的 Muse 能“打电话”了:实时语音加会做表情的虚拟形象,先推美国
11 月 6 日,扎克伯格在 Threads 上发帖宣布,Meta 的个人 AI 助手 Muse 上线实时语音对话和富有表现力的虚拟形象,美国用户先用上,覆盖移动端、网页端和 Mac 应用。变化很直观:点应用右上角的电话图标,就能像给一个人打电话那样跟它说话,它说到一半,你随时可以打断。
打断为什么难
拿日常打电话打比方。你插一句话,朋友会立刻停住,顺着你的新话头接下去。AI 要做到这个,得在自己还在“说话”的同时听你插话,判断从哪个词停下、把没说出口的后半段丢掉,再重新组织回答;画面里的口型和表情还得跟着新语流重新对上。这些事情都要在不到一秒里完成,否则就像对讲机,来回一卡一卡。
Meta 的做法是两个模型分工:Muse Realtime Voice 同时生成“说什么”和“怎么说”,语气、停顿都算在后者里;Muse Realtime Avatar 基于同一条数据流实时生成表情、口型和肢体动作,让声音和画面天然同步。Meta 称可流式输出 448×768 分辨率、25 帧每秒的竖屏视频,从你讲完到收到第一个音视频响应约 870 毫秒。这是厂商自报的数据,没说明怎么测的,实际手感还得上手才算数。
三种看法,几百种嗓子
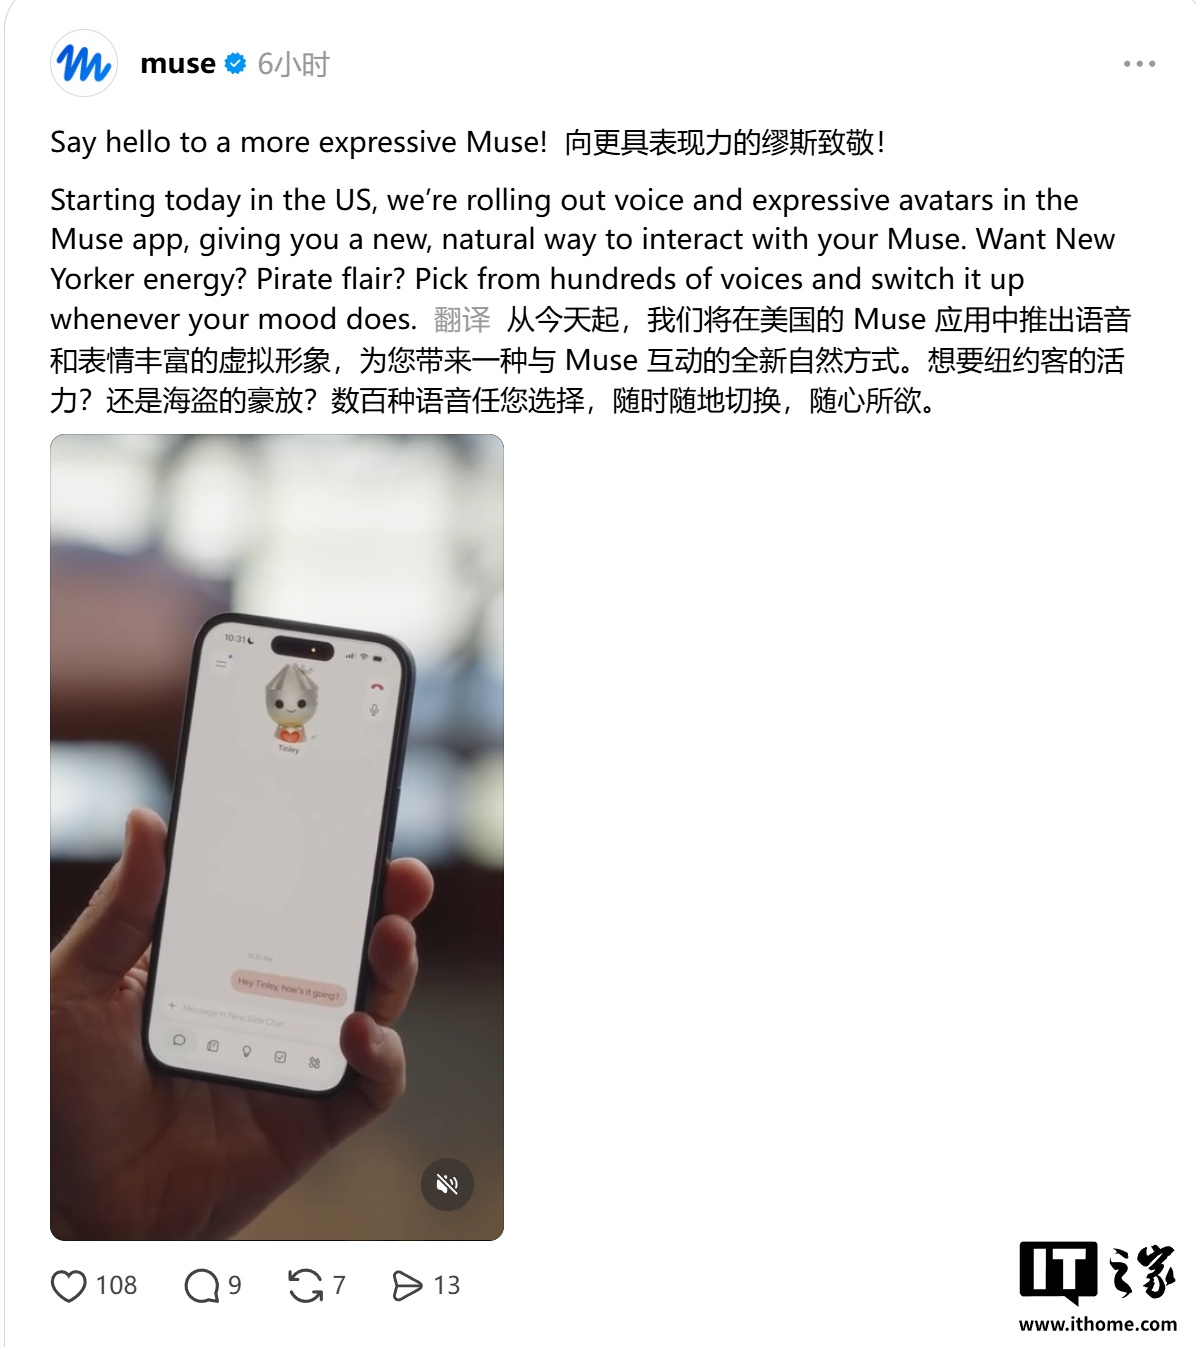
交互分三档:只用语音、在聊天界面旁边挂个小形象、切到全屏“面对面”。默认形象是个叫“Jolly”的卡通角色,可以换成人物、动物或其他角色;声音有数百种风格,官方举的例子包括“纽约客式活力”和“海盗风”。Meta 设想的用法是散步、双手忙的时候口头派活,Muse 在后台接着做;也能用来头脑风暴、订旅行、练面试或演讲。官方还演示了让形象跳舞并分享到 Instagram、Facebook 或 WhatsApp 的玩法,这项是否跟本次更新一起上线,报道里没说。
先把边界划出来
448×768、25fps 这个规格,比日常视频通话低不少,全屏“面对面”现在更像一个会说话的卡通窗口,不是真人对视的感觉。另外几件事目前没有明确答案:是否免费、有没有用量或订阅门槛;国内能不能用,美国先推大概率意味着需要美国区账号和相应网络条件;Muse 和 Meta AI 是更名还是两个产品,报道也没交代。这些先记成问号,不下结论。
已经实现的,是“能打电话、能被打断、有表情地回应”这件事本身。它比排队等一整段回答自然得多,这也是个人助手从“问答框”往“在场的人”迈出的一步。但一边走路一边口头派活到底顺不顺手,870 毫秒在实际对话里够不够,得等真实用户用一段时间才知道。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] Meta 给 AI 装上“脸”和“嗓子”:Muse 现在能视频聊天了
- 配图 1:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 2:来源:www.ithome.com(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。