
GitHub 重建 Git 存储架构:为一个仓库同时接收成千上万个智能体的提交
作者:陈一帆
GitHub 工程博客发布代号"Rubicon"的新 Git 存储架构,让单个仓库一次承接数千个 AI 智能体的并发推送。核心是把写入共识从"整仓库加锁"收缩到"只锁引用更新",再用无状态虚拟副本与对象存储把读写各自独立扩容。内部测试演示了一仓 5000 并发智能体、每秒 7200 次推送;不过这些都是官方自测数据,全量上线时间表尚未给出。
GitHub 工程团队 11 月 5 日在官方工程博客发布《Inside GitHub's new Git storage architecture》,公开了为智能体开发重建的 Git 存储层,代号"Rubicon"。设计目标很直接:让单个仓库承接每秒数千次写入。内部测试中,一个仓库同时跑 5,000 个并发智能体、每秒 7,200 次推送,读取延迟仍保持平稳 。这套架构上周先在 GitHub Universe 大会宣布,这次是完整的技术拆解 。
旧机制为什么撑不住
想象一份共享文档:每个人手里都存着完整副本,谁要保存修改,就得先锁住整份文档,等所有持有人逐一确认才算数。传统 Git 托管正是这个思路——每台副本都存全仓库数据,每次写入要拿仓库级锁,最慢的那个副本决定所有人的写入延迟 。
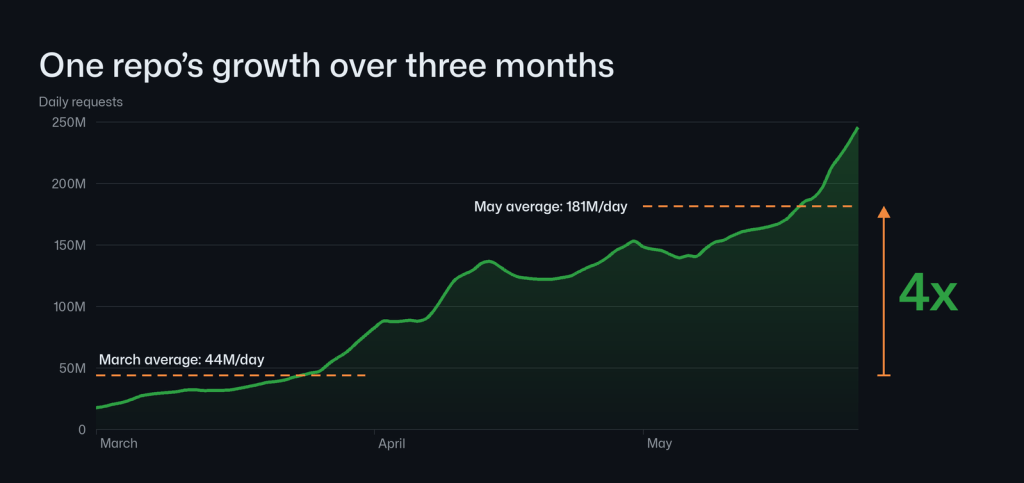
少量人协作没问题。但智能体把偶发的写入爆发变成全天候的持续流(GitHub 预期一年内就会成为常态),而且每次推送还会带出放大效应:CI 要拉、部署系统要拉、别的智能体也要拉来当上下文 。GitHub 给了一个观察样本:某个仓库的日均请求从 3 月的 4,400 万涨到 5 月的 1.81 亿,约 4 倍,此后还在指数往上走 。
Rubicon 的关键一招:只对"引用"达成一致
整个设计压在一个观察上:一次推送里,真正需要多方"达成一致"的只有引用(分支指针)的更新;Git 对象是不可变、按内容命名的,谁都可以先写进去。于是持久数据拆成两处,计算另成一层 :
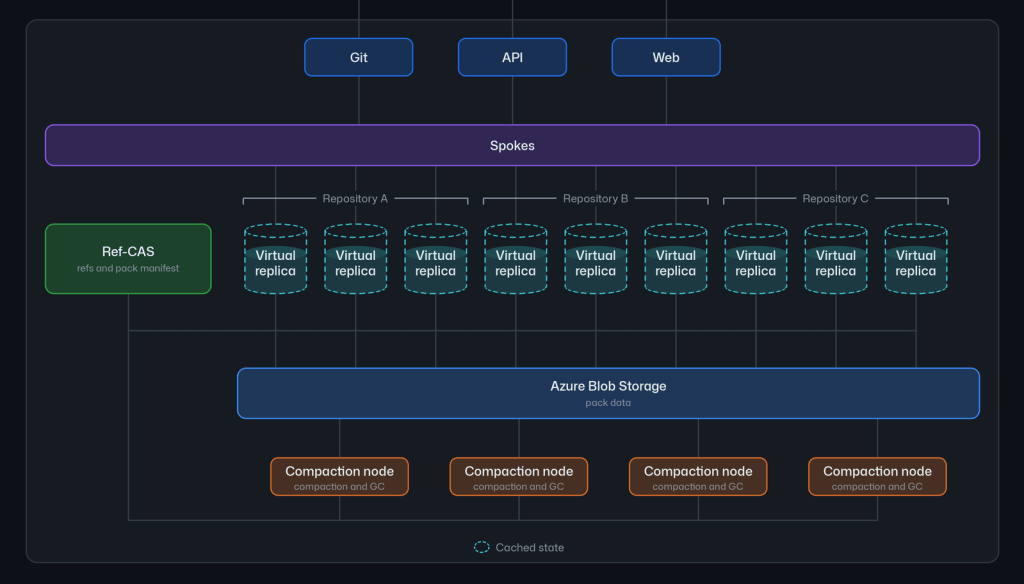
- 虚拟副本:一队可随时丢弃的计算节点,本地磁盘只是缓存,仓库变忙就加机器,坏一台不影响正确性;
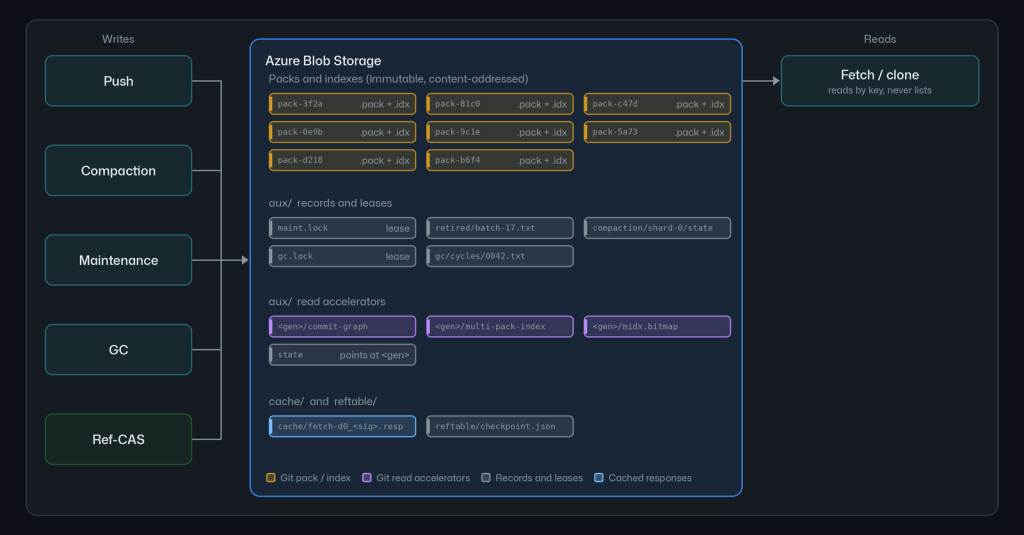
- Azure Blob Storage:存 Git 对象(pack、索引、读加速数据),绝大多数内容写一次就不再改动,天然适合对象存储;
- Ref-CAS:专管引用和 pack 清单的复制日志服务。每次引用更新是一次比较并交换(compare-and-swap),只锁它碰到的那几个引用,多数副本记下即可提交。智能体大多推自己的分支,冲突很少,引用状态单独能做到每秒数万次操作 。
写入路径:副本先把 pack 索引好、传上 Blob 存储,再向 Ref-CAS 提交一笔事务,写明清单和引用——引用永远只指向已经落盘的数据 。读取路径:副本只对版本号做一次比对,没变化就零成本返回;落后了才去拉需要的那部分数据 。写入变多带来的"pack 碎片化",交给后台的压实节点用租约分片认领处理,pack 数量在写入攀升时大致保持平稳,垃圾回收也不再抢服务请求的资源 。
值得一提的是他们试过的两条弯路:把全部引用塞进单个 blob,写入吞吐卡在每秒几百次;按哈希拆成多段 blob,又把读延迟拖慢——最终才落到专门的 Ref-CAS 上 。
前情与边界
这是该系列第三篇。2025 年 8 月起,GitHub 已把 99.99999% 的仓库迁进 Azure,并把写入仲裁从整仓库缩小到单个引用,内部实测不同引用的写入吞吐提升 3–4 倍;平台上读写比常态是 100 到 1000 比 1 。这次是在那基础上把仲裁进一步收紧、把计算彻底做成无状态。
对开发者,Git 还是 Git:推送、拉取、建分支的方式都没变 。不过边界得说清楚:5,000 个智能体、每秒 7,200 次推送是 GitHub 官方内部测试的数字,目前没有第三方独立测试可对照 ;那条 4 倍增长曲线来自哪个仓库,官方没披露;新架构是"边跑边建"地铺开,虚拟副本是仓库迁入的入口 ,但全量上线时间表没给。按对象类型拆 pack、局部副本、把智能体会话上下文存到提交旁边等,都还列在"接下来"的计划里 。
方向确实对路——把"必须排队"的部分压到最小,让读写各自扩容,这个工程判断我认同。但今天能确认的事实是:架构已发布、测试已演示。"每个人的仓库都用上"这一步,还得等官方后续公告。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] Inside GitHub’s new Git storage architecture
- [S2] Inside GitHub’s new Git storage architecture
- [S3] The GitHub Engineering Blog
- [S4] The bridge to agent-scale Git infrastructure
- 配图 1:来源:github.blog(图片署名见原文) · 图片出处
- 配图 2:来源:github.blog(图片署名见原文) · 图片出处
- 配图 3:来源:github.blog(图片署名见原文) · 图片出处
- 配图 4:来源:The GitHub Blog(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。