
白送的 280B:百度开放 ERNIE 5.5 Flash Base 权重,开发者拿到手能做什么
作者:周砚
百度把 ERNIE 5.5 Flash 的预训练终点权重放了出来:总参数 280B、每 token 激活 14B、33.5T tokens 从零预训练。这不是能直接对话的模型,而是一个起点。它省掉了最贵的那一段,也把"开源竞争"的比法从聊天效果挪到了基座质量上。腾讯 Hy4 的说法目前仍只有社交平台孤证。
先看清放开的是什么
11 月 5 日,百度文心发布 ERNIE-5.5-Flash-Base,开放 ERNIE 5.5 Flash 预训练终点的权重 。几个关键数字:稀疏 MoE 架构,总参数 280B,每个 token 只激活 14B;在 33.5T tokens 上从零完成预训练;训练上下文最长 128K,微调与推理支持到 1M tokens 。
名字里的 "Base" 是重点。这批权重没有经过中训练,也没有经过后训练 。说白了,它不是拿来聊天的:你问它一个问题,它更可能顺着往下写,而不是回答你。官方也直说,Base 只是起点,经过后训练的 ERNIE 5.5 Flash 随后推出 。
280B 和 14B 的关系也值得解释一句。280B 是模型的总容量,14B 是每次计算实际动用的部分——稀疏 MoE 靠路由挑选专家,只有一部分参数参与单个 token 的运算。结果是:显存和存储要按更大的模型准备(FP8 权重按 280B 粗算是 280GB 量级),但算力开销更接近 14B 这一档。这类架构省的是推理时的计算,不是部署时的机器。
对开发者、研究者,实际用途在哪
33.5T tokens 从零预训练,是这件事里最实的部分。这个量级的训练成本,独立实验室和高校基本无法复现,把终点权重放出来,相当于让别人省掉最贵的一段,只付微调的钱。官方给的三个方向也都指向这里:领域适配、指令微调、强化学习研究的共同起点 。
拆开看:
- 领域适配。拿通用基座继续喂行业语料,比从一个已经对齐好的聊天模型改,阻力小得多——后训练过的模型带有固定的回答习惯,你想让它换一种风格,往往要和旧习惯打架。
- 指令微调。做垂直助手、小语种模型,从 Base 起做 SFT,可控性更好。
- RL 研究。在别人调好的模型上做强化学习,很难说清涨点是来自你的方法还是它原有的对齐;Base 是可复现的干净起点。
语料设计里有个细节能说明官方对下游的预期:代码数据除了仓库与网页代码的去重分级,还补了 commit、issue、pull request、代码评审、自动生成的测试、经 CI 验证的修复 。这些是"软件演化与执行验证"类数据,典型的 agent 后训练原料。长文方向同样如此——天然长文档、混入语义相近干扰文本的长序列,加上合成的检索与多跳问答 。基座层面就在为"读长文档、查东西、改代码"铺路。
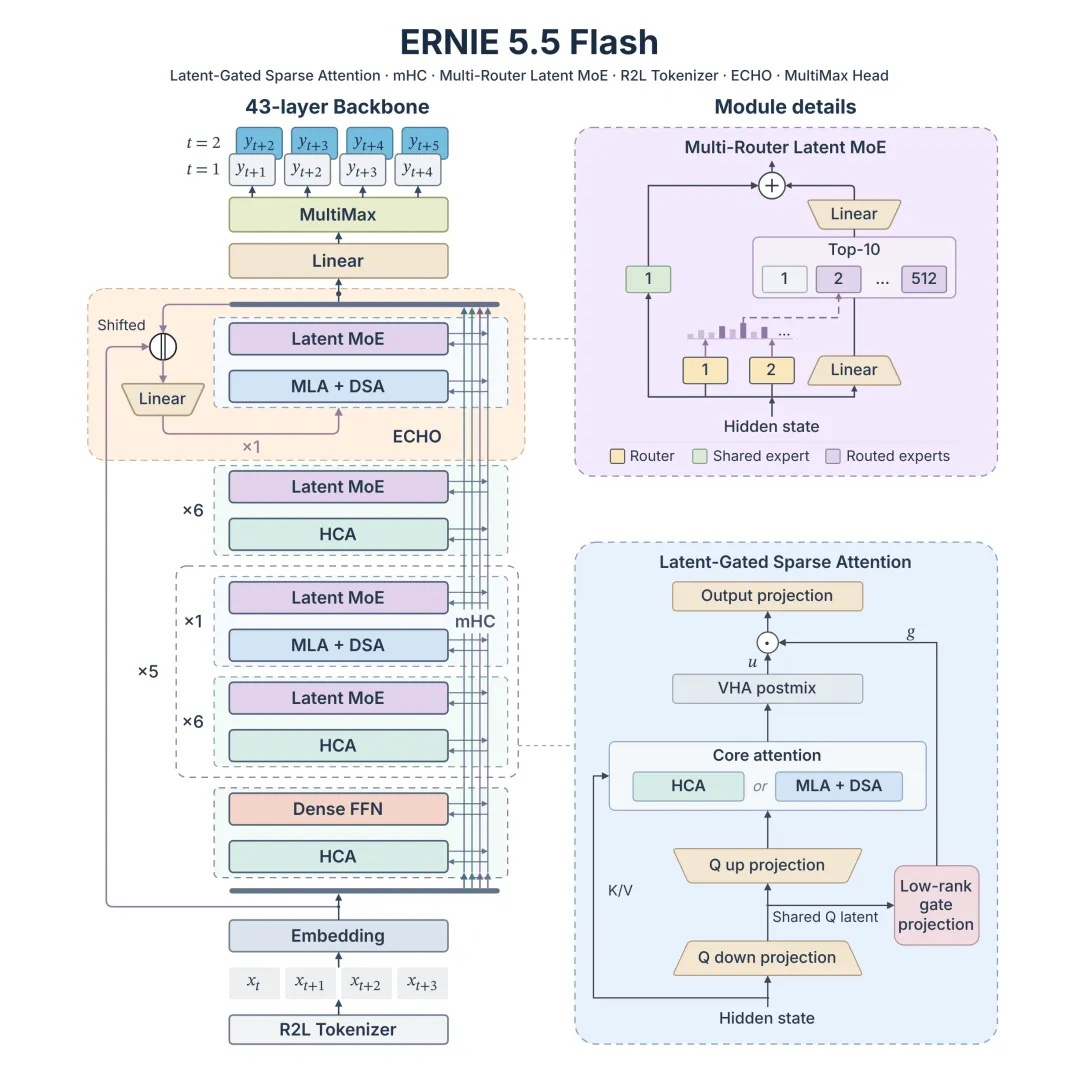
至于 1M 上下文,得分清两件事:训练时最长 128K,1M 是微调与推理阶段的支持 。自评里提到,43 层中有 37 层在 128 倍压缩后的序列上做注意力,6 层 MLA-DSA 负责细粒度检索 ——这是结构上的取舍,能不能在 1M 位置真的捞回细节,还要看第三方复测。
腾讯那条线,目前只能算线索
和百度这条有官方链接、有权重地址的消息相比,11 月的另一条传播线要弱得多。
11 月 4 日,小红书一篇帖子称腾讯 Hy4 正式版能看懂屏幕、自己操作微信,实测让它总结群聊、改资料,还会用 Blender 建 3D 模型;API 价格看齐 DeepSeek,开源权重已放出,昇腾算力适配好了 。这条帖子后来打不开(返回 404),也没有官方公告、许可证条款、权重托管地址或具体价目可以对照。所以"开源"和"看齐 DeepSeek"目前都只能标注为待核实。
即便这些说法成立,也要看清楚它和百度那条不是同一类东西。"自己操作微信"属于 GUI agent 能力,靠的是后训练加一层执行框架,涉及截屏识别、点击、失败重试。这类演示的说服力取决于成功率和回滚机制,而这两项恰恰不在传播内容里。另一个常被忽略的点是合规:自动化操作自家社交 App,边界在哪,需要官方说明,而不是实测视频。
X 上的传播则是另一种形态。11 月 5 日,账号 @Sui_hunter 发了一句 "BAIDU JUST GAVE AWAY A 280B AI MODEL FOR FREE" 。它没有任何技术细节,价值在于说明海外的时间线确实被这个数字带动了。但"白送"至少要打三个折扣:权重免费不等于算力免费;许可证条款在发布信息里没出现,商用授权要另看;能直接用的后训练版还没发。
竞争比的是起点,不是聊天效果
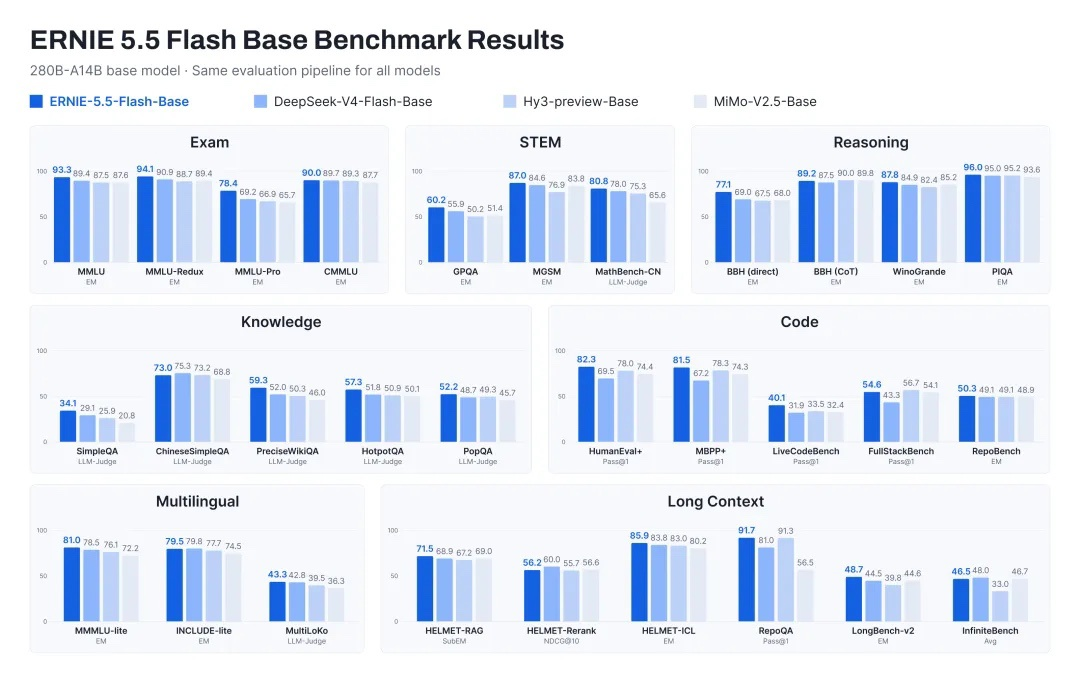
官方在 30 项 Benchmark 上与三个同等规模的 Base 对比:DeepSeek-V4-Flash-Base、Hy3-preview-Base、MiMo-V2.5-Base,都用各自公开的 checkpoint、同一套评测框架 。这份榜单的意义不在排名,而在于它把竞争坐标改了:大家比的不是谁的聊天模型讨喜,而是谁的基座更值得被选作起点。
这是一门收益后置的生意。Base 权重本身几乎不直接产生收入,回报在别处——研究者熟悉你的结构,工程示例里默认带着你的微调配置(官方就附了英伟达 Megatron-Bridge 的示例 ),企业做行业模型时你的架构成为默认选项。代价是持续的:预训练一轮比一轮贵,语料清洗和 CI 验证数据要一直投,而后训练版的发布节奏还得跟上,否则起点会被别人抢走。能长期这么打的,是现金流够厚的少数几家;中小团队在这轮里更多是受益方,而不是参赛方。
需要交代证据局限:核心参数来自 IT 之家对官方发布的转述 ,官方技术博客与 Hugging Face 模型卡本轮未能读取,30 项 Benchmark 是厂商自评,没有第三方复测分数,许可证条款未知;腾讯 Hy4 的整条信息缺官方确认。所以"谁更强""价格战会不会真打起来",现在下判断都太早。
接下来两个时间点值钱:ERNIE 5.5 Flash 后训练版发布时,才轮到比聊天和 agent 能力;Hy4 若真有官方开源公告和定价页,那条线才算成立。在那之前,"白送 280B"是个传播上准确的标题,但还不是完整的事实。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] 百度文心开源发布 ERNIE 5.5 Flash Base 高效基座模型,总参数 280B
- [S2] 腾讯Hy4正式版实测:AI会自己操作微信了 · 谁是我的黑马
- [S3] BAIDU JUST GAVE AWAY A 280B AI MODEL FOR FREE 😳 · Sahinul
- [S4] 小红书 - 你访问的页面不见了
- 配图 1:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 2:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 3:来源:www.ithome.com(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。