
从人工耳蜗到机器听觉:两条线都在问「听是怎么来的」
作者:陈一帆
HN 上一位双侧人工耳蜗使用者贴出了自己的听觉心理物理学笔记,同期 MIT 介绍了 Paris Smaragdis 的机器听觉研究。两条线的工程共性是把窄带宽的信号交给一个会学习的解码者;差别在于,人耳这条线的学习者是人,机器那条线的学习者只能靠数据。需要说明的是,前一条线本轮只读到元数据,正文与评论未核实。
文 / 陈一帆
十月底到十一月初,有两件事先后出现在我的信息流里。10 月 28 日,MIT News 发了一篇特稿,讲电子工程与计算机科学系、音乐与戏剧艺术项目双聘教授 Paris Smaragdis 怎么让机器学会听 。11 月 5 日,Hacker News 上有人贴出一篇题为《My psychophysics as a bilateral cochlear implant user》的东西,20 分,4 条评论 。
两次发布挨得近,纯属巧合,不必编排成什么趋势。但两个标题放在一起确实有点意思:一个在问人怎么把声音重新接上,一个在问机器怎么学会分辨声音。说到底都是同一件事——听是怎么来的。
先说清楚我读到了什么
这次的材料是不对等的。MIT 那篇我拿到了全文 ;HN 那篇只拿到元数据:标题、链接、分数、评论数,正文托管在 claude.ai 的一个可分享工件页上,评论区 4 条,都没读到 。
所以下面的写法是:机器听觉那条线按原文梳理;人工耳蜗那条线只当作线索,讲清它为什么值得看,但不替作者猜结论,也不编他的感受。
人工耳蜗:绕过坏掉的那个零件
先讲个日常场景。你把耳机音量往上推,耳朵里那层毛细胞把空气振动转成电信号,交给听神经,再送到大脑。整条链子上,最脆弱的是毛细胞那一段——它坏了,后面全都白搭,声音再大也进不去。
人工耳蜗的思路不是修好它,而是绕过它:麦克风收声,处理器把声音拆成频带、压缩成电刺激的参数,电极阵列贴在耳蜗里直接去捅听神经。这一步是通了,但神经收到的不是自然的声波编码,而是一套人工规定的电流模式。剩下的事得交给大脑:几个月里,它得重新学着把这种陌生的输入翻译成「有人在叫我」「这是钥匙串」。双侧植入的意义也在这里——两只耳朵之间的时间差和强度差,是定位声音来源的原料。
以上是通识背景,不是这两篇来源里的事实,具体的电极数量、频带划分我这里不报数字。
那「心理物理学」是什么?简单说,就是量「物理刺激」和「主观感觉」之间的对应关系:把「听起来多响」「听起来多高」和可测量的声音参数对上。对一般人是实验室里的曲线;对 CI 使用者,这套测量尤其贴身,因为设备和感觉之间那层翻译是人工做的,哪里不对、差多少,只有戴着它的人能说。
标题里这个用法说明作者想做的不是抒情,是量化自己的听觉。具体测了什么、结论是什么,我没读到正文,就不展开了。
MIT 那条线:从合成器到「教机器听」
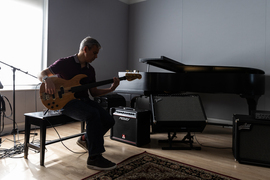
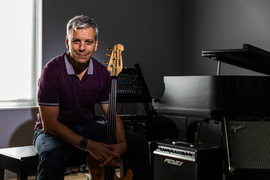
Smaragdis 的路径挺有意思,不是标准学术路线 。他在希腊长大,弹古典吉他,转折点是父亲带回家一台小合成器——那台机器能自己造音色,他从此迷上「造出没听过的声音」。后来去伯克利音乐学院,主修贝斯(他觉得贝斯在声音上更有意思,也更少人做),跟导师 Richard Boulanger 一起做工具;又和 MIT 媒体实验室的 Barry Vercoe(2025 年去世)合作软件合成器,之后在 Vercoe 组里读完硕士、博士和博后 。
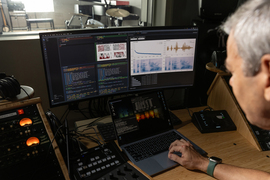
媒体实验室当时多数人用信号处理,他挑了机器学习这条路。他的说法是:我们得「教」计算机怎么听,不能只是「告诉」它怎么听——因为我们其实不知道自己是怎么听的,也没有一套词汇能解释听一只猫叫和听一把小提琴有什么区别 。这句话正好扣住这次的主题。
之后是三菱电机研究实验室:让系统扫视频的音轨、判断画面里发生了什么。他举的例子很具体:录完整场足球赛只想看集锦,视觉上很难定义什么是「精彩」,但观众一炸,你就知道有事发生了。这套东西后来进了录像设备、交通监控和手机 。再往后是 Adobe,他从零建起音频研究团队,做面向创作者的好用工具;然后是伊利诺伊大学香槟分校十五年,把神经网络带进音频处理 。
中间有一件被反复传播、但值得说准的事:《The Beatles: Get Back》的制作团队用了他们的神经网络声源分离技术清理档案录音,2022 年拿了非虚构/纪实类节目的声音剪辑艾美奖 。奖项是给制作团队的,Smaragdis 是受聘的技术贡献者,传播里常把这两者合并成一句「他得了艾美奖」。工程细节也有意思:学术里追求指标好看,这里只要「听起来对」,没有可优化的公式,每段录音的麻烦都不一样——比如列侬在弹琴,麦卡特尼在旁边念报纸上的标题逗哈里森 。
2025 年他入职 MIT,现在主要做两块:让机器听懂音乐、能给演奏者建设性反馈(他的原话是增强乐手的工具箱,不是替代乐手);以及更基础的音频表征工具,比如采样率、帧长、上下文窗口都不再固定甚至不再定义的信号处理框架 。另外也在试把大语言模型接到语音识别和音频增强里 。
两条线的共性,和真正的差别
共性可以概括成一句:都是编码加解码,送出去的可用信息都比自然听觉窄,缺口靠学习和训练来补。这条是我自己的分析框架,不是两篇来源里的结论 。
差别在谁是那个学习者。
人工耳蜗是闭环的:处理器的参数可以调,但真正的适配发生在使用者的大脑里,需要时间、需要练,而且人和人差别很大。这正是心理物理学式自述的价值所在——它是从「感觉那一端」往回写的记录,实验室的曲线替代不了。
机器听觉是开环的:模型背后没有一个正在慢慢适应的脑子,只能靠数据、标注和损失函数。好处是学得快,也能在某些任务上超过人,比如从混录里把某个声源抠出来;代价是「理解」被拆成了一堆具体任务,每换一个场景就得重新调。
另一层差别是产品节奏。CI 是医疗器械,改动慢、验证严,一次小升级都要过临床试验;机器听觉进产品快得多,手机、监控、录音软件里已经在跑。所以前者谨慎、后者激进,是行业结构决定的,不是谁更聪明。
边界要写清楚
Smaragdis 自己有一段很克制的表述:AI 是个极其强大的工具,但我不认为我们已经找到在声音和音乐上使用它的理想方式 。
特稿开头那两段「超人听觉」——靠轮胎尖啸和金属撞击声定位车祸、听出地热井钻头什么时候要坏——是愿景场景,文中没有给实测数据 。这不是否定,只是把「已经做到」和「想做」分开。已经做到的,是《Get Back》里那种从混录素材中分离声源的能力,是手机和监控里跑了很多年的声音事件判断;还没做到的,是真正稳定、能在任何现场都靠得住的听觉理解。
至于那条 HN 帖子,我这次只确认了它存在、发布形式是 Claude 工件页、讨论度不高(20 分、4 条评论)。作者是谁、笔记里具体写了哪些观察、评论里有没有其他 CI 使用者印证或反驳,全部待核,个人自述也不能当临床证据用。但它是个好问题:如果一个人愿意自己动手去测「我听到的响度和音高到底怎么变」,他做的其实已经是心理物理学了。等能读到原文,这两条线或许真能对上;现在,它们只是同一周里两个关于「听」的入口。
一个是从坏掉的零件开始,一个是从没有词汇开始。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] My psychophysics as a bilateral cochlear implant user
- [S2] Making machines that can listen
- 配图 1:来源:MIT News | Massachusetts Institute of Technology(图片署名见原文) · 图片出处
- 配图 2:来源:MIT News | Massachusetts Institute of Technology(图片署名见原文) · 图片出处
- 配图 3:来源:MIT News | Massachusetts Institute of Technology(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。