
248GB 的量化文件塞进 12GB 显卡:DeepSeek V4.1 Flash 本地能跑了,就是慢
作者:陈一帆
ISTA-DASLab 放出 DeepSeek V4.1 Flash 的 2-bit 量化文件,共 248.84GB,靠 Strata 引擎把显存、内存和 NVMe 当成一个层级来用,12GB 显卡真能跑起来。但速度只有 4–11 tok/s,真正的门槛是 46–64GB 内存和一块快硬盘,不是显卡。
先发生了什么
十月最后一周,本地部署圈里流传一组数字:248.84GB 的模型文件,12GB 的显卡,能跑。听起来像算术出问题。其实没错,只是“能跑”的关键不在显卡上。
10 月 23 日,奥地利科学技术研究所的 ISTA-DASLab 在 Hugging Face 放出 DeepSeek V4.1 Flash(1017 修订版)的三套 GGUF 量化文件,比特率从 1.75 到 2.25 bits per weight,MIT 许可,可商用 。被推荐的是 IQ2_XXS 那份,卡面总量 248.84GB 。另有开源运行时 Strata 负责把它拆到不同硬件上,并附带一份 8GB 左右的草稿模型用于投机解码 。
所以标题没说谎,只是它同时暗示了一件不成立的事:以为升显卡就能解决。
三个数字,三个问题
这类新闻最容易混的,是磁盘占用、运行时占用和带宽。
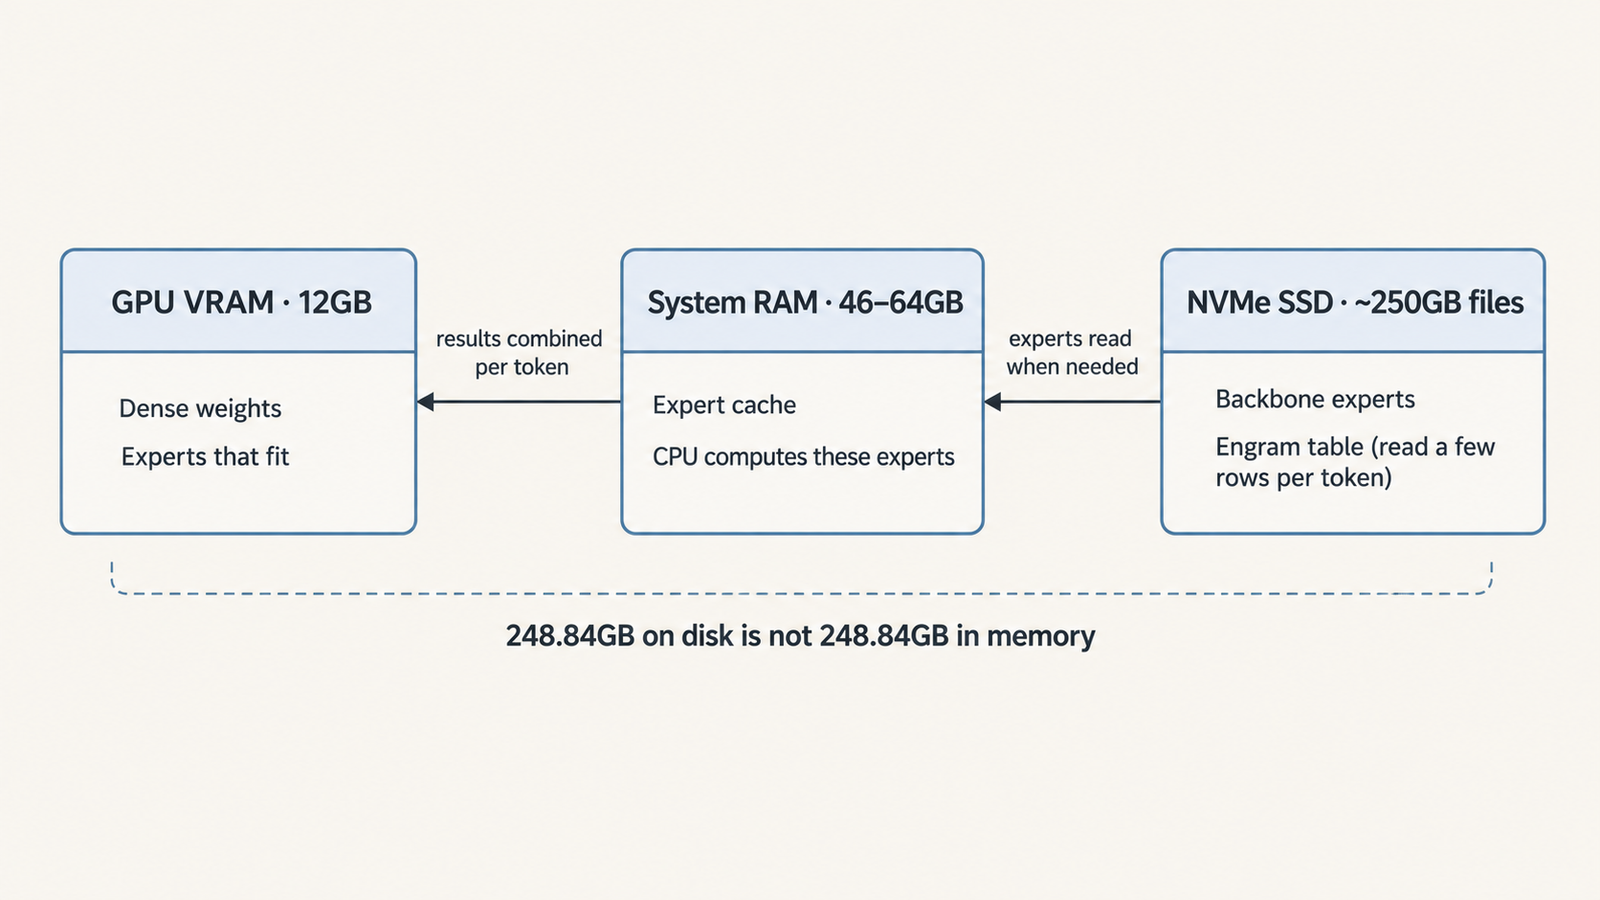
248.84GB 是硬盘的账:骨干 138.24GB,加一个共享的 Engram 文件 110.60GB 。它并不是内存需求,也不是显存需求。第二篇资料按字节从接口读出来是 128.75 GiB 加 103.00 GiB,合计 231.74 GiB ,换成十进制刚好对得上——这是单位口径差,并非矛盾。
第三个才是关键:带宽,也就是每个 token 要用到的权重能不能及时送到算它的地方。前两个能过关,第三个过不了,一样卡。
为什么能拆着跑
底气来自模型结构。DeepSeek V4.1 Flash 是 763B 参数的混合专家模型,每层 384 个专家,路由器只给每个 token 挑 6 个;解码时激活约 16B 参数,预填充约 8B 。名字里的 763B 是全部家当,不是干活时的分量。
还有 196B 参数不参与矩阵乘法,是一组叫 Engram 的查找表,按 token 查行读出来 。正因为读的是行、不是整张表,这 110.60GB 留在硬盘上才不至于把速度拖死。
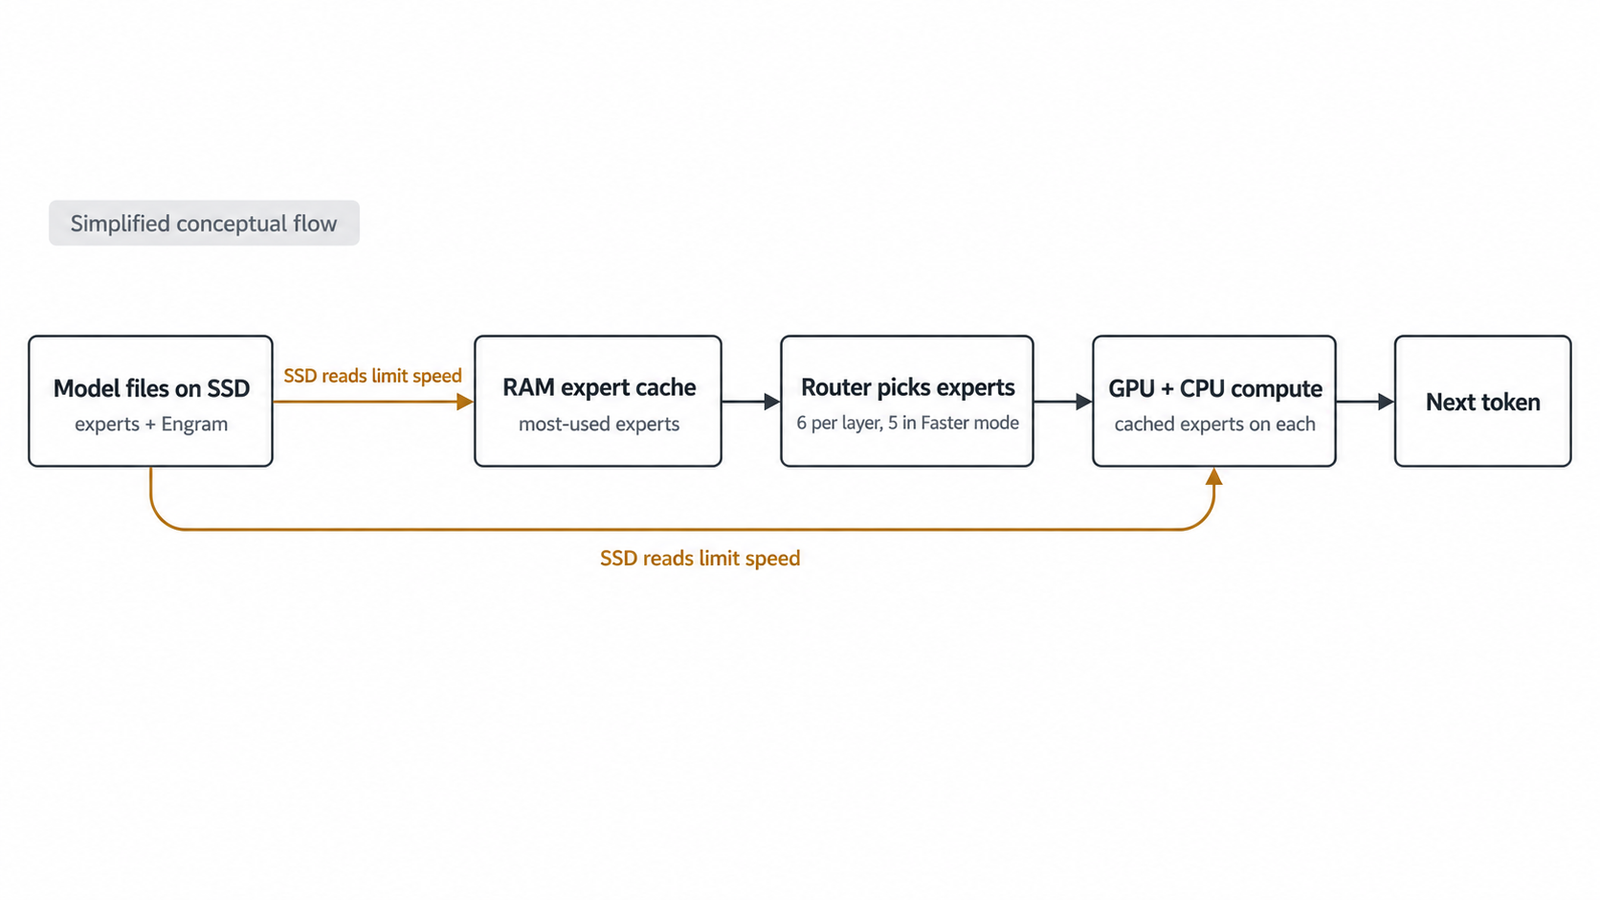
Strata 顺着这两点搭了储物层级:GPU 放稠密权重和装得下的专家;系统内存当专家缓存,最常用的那批交给 CPU 算;再装不下的从 NVMe 随用随读。引擎还自带热门专家档案,缓存不至于从零冷启动 。像厨房里工作台、抽屉和储藏室的分工——台面小没关系,常用的家伙什在手边就行。
而系统原生的内存映射方案在同一台 RTX 5070、64GB 内存上只有 1.8–2.2 tok/s,Strata 的专家缓存跑到 4.3–4.9 。同样的文件,缓存策略差一倍速度,这大概是整件事里最值得记住的工程细节。
速度:能算明白的慢
粗算一下下限:假设 16B 激活参数全按 2 bit 从盘上读,每个 token 约 4GB;按 3.6GB/s 的 NVMe 算,每秒大约 1 token 。实测能到 4–11 tok/s,说明大部分权重是从缓存里拿到的。
实测里最反直觉的一条:46GB 内存的 RTX 3060 12GB 跑出 9–11 tok/s,64GB 内存的 RTX 5070 12GB 反而只有 4–6 。项目方没解释这个差距,两台机器的 CPU、硬盘、内存配置都不同。但它至少说明,这里的瓶颈不是显卡新旧。
时间账得提前算。2000 token 的回复约 6.7 分钟;默认 32K 的思考预算如果真用满,光思考就近 1 小时 50 分钟 。同一件事交给 API,输出速度约 184 tok/s,百万输出 token 收费 1.20 美元 。本地这套属于“能用”,离“好用”还有距离。
“100% 恢复”该配什么说明
量化方报告 IQ2_XXS 在 AIME25、GPQA-Diamond、LiveCodeBench v6 上与原始模型分数完全一致 。三列里 AIME25 原模型已经是满分,这一列只能证明“没变差”。而 Strata 在 4995 个文本位置上测同一份文件,困惑度高出 15.5% 。
两组结果都能成立:推理基准可以打平,token 分布照样漂移。同一张表里,IQ2_XS 是 +7.3%,IQ1_M 是 +21%,其中纯英文散文一项到 +53% 。写代码、跑 agent,2.00 bpw 够用;写长文,别选最省的那档。
还有一个容易被名字骗过去的地方。这份“2-bit”文件里,120 个专家张量有一半其实是 IQ1_M,0 到 6 层干脆全是 IQ1_M,IQ2_XS 直到第 17 层才出现 。平均值是个会计数字,不是均匀分配。
另外,显存 16GB 及以下的机器默认走“5 选 6”的快速模式,而两套评测都没说明自己用的是不是这个模式 。要比数据,得先确认设置对齐。
值得高兴的部分,和它没说的部分
第二篇资料的前一篇结论还是“没有消费级机器跑得动”,一个月后自己改了口 。763B 量级的开源权重能落到一张 12GB 卡上,靠的不是某一项黑科技,而是模型结构、量化方法和运行时调度三件事同时到位。这个方向我认为是对的:把“显存不够、硬盘来凑”从一句口号变成了一套能复现的配置。
边界也很清楚。目前能加载这套文件的只有 Strata 一个引擎;Mac 没有运行时 。原版 llama.cpp 的兼容状态两篇说法不一:一篇 10 月 25 日读到的结论是元数据键与上游不符、加载失败 ,另一篇说 b11870 预发布起已支持、文件 10 月 27 日起对齐新布局 ,时间线可能是解释,但没有定论。所有速度数字都出自引擎作者自测,还没人独立复现 。Strata 的版本号两份资料也对不齐(0.2.4、0.2.5、0.2.7)。
想试的话,顺序别搞反:先看内存够不够 46GB、有没有富余的 245–280GB NVMe 空间,再看显卡,最后掂量自己的耐心。这套配置里最便宜的就是那张 12GB 卡——它恰好是最不该先升级的部件。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] How to Run DeepSeek V4.1 Flash Locally on a 12GB GPU
- [S2] DeepSeek V4.1 Flash GSQ-RCO Quants (2026): 12GB GPU, No Mac
- 配图 1:来源:UniverseBlend |(图片署名见原文) · 图片出处
- 配图 2:来源:UniverseBlend |(图片署名见原文) · 图片出处
- 配图 3:来源:UniverseBlend |(图片署名见原文) · 图片出处
- 配图 4:来源:UniverseBlend |(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。