
这条回复真是那个模型写的吗:FlashProve 给 AI 输出配了一张可验证的收据
作者:陈一帆
Anthropic 在 11 月 2 日开源 FlashProve,用 zkSNARK 把每条回复绑定到一组被承诺的权重上,普通 CPU 就能核验,不用拿到权重。它同时暴露了一串边界:只覆盖贪心解码和 1024 token 上下文,证明成本是同规模推理的 72~94 倍,而且证明的是“出自这份权重”,不是“这份权重没被动过”。
先说清楚发生了什么
11 月 2 日,Anthropic 在 GitHub 上开源了 FlashProve,Apache 2.0,版本号 0.16.0。仓库最上面贴着一行标签:研究产物,不维护,不接受贡献 。这句话得放在最前面,因为它决定了后面所有数字该怎么读——这是一个能跑通真实大模型的实验品,不是等着上线的产品。
它想解决的问题很日常:你调一个 API,回复很漂亮。但漂亮不能告诉你这是哪个模型生成的。中间可能有一层路由,把请求转给更便宜的系统;评测的时候,被测方可能拿到的是另一个模型;也可能有人在返回的路上把 token 改了 。
要自己核实,就得把模型重跑一遍。可权重是私有的,硬件也不便宜。这条路对普通用户基本是关着的 。
三步:封条、收据、验章
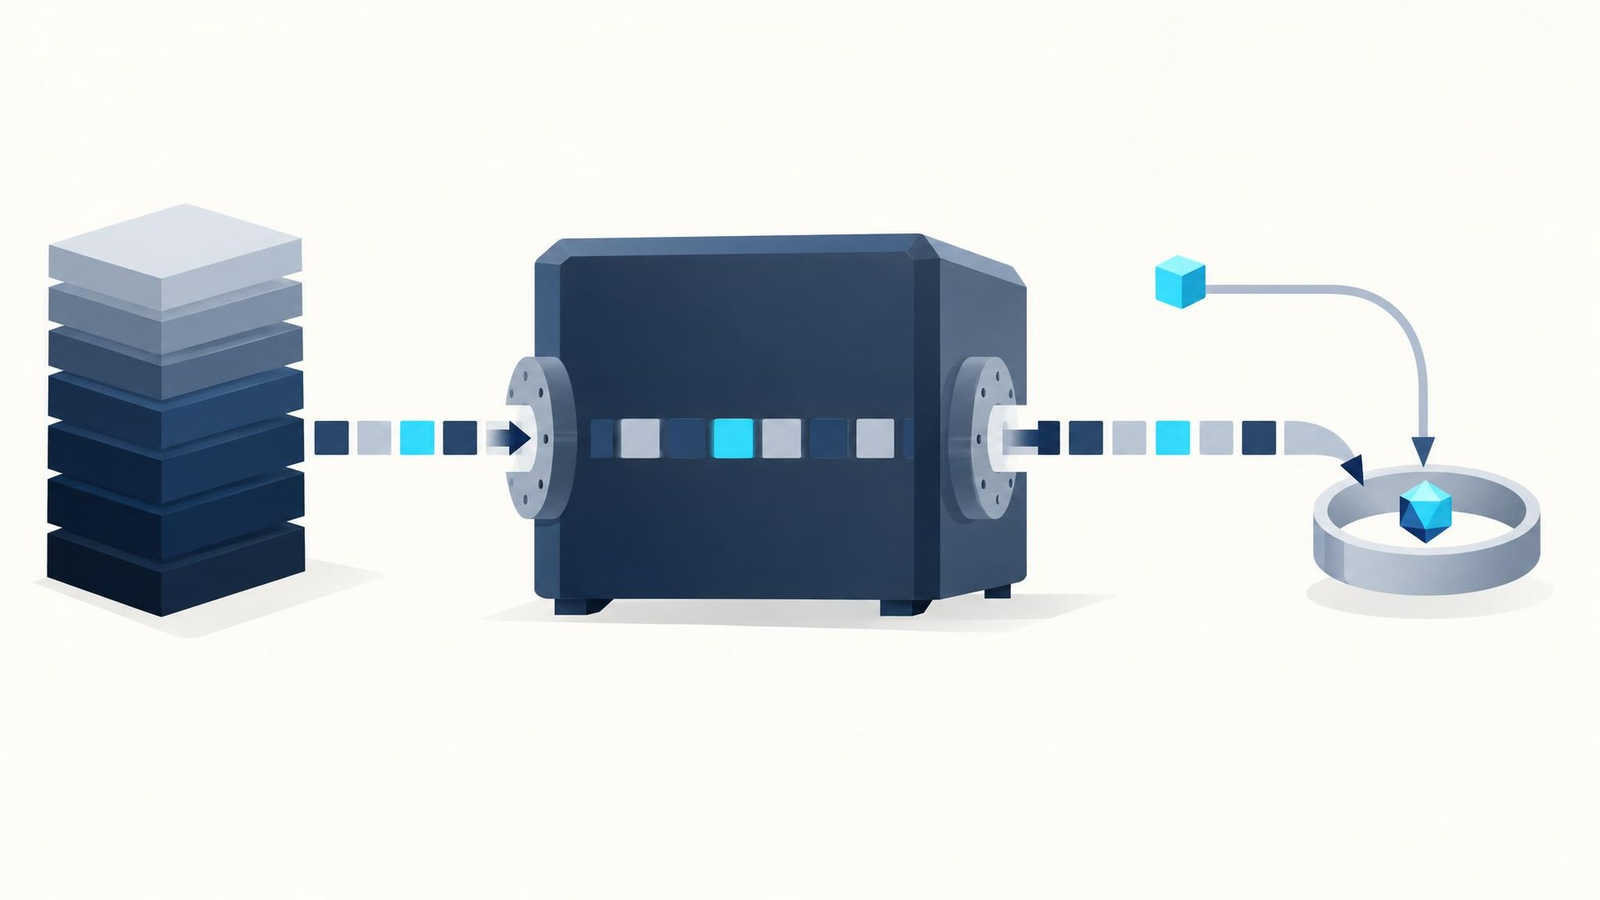
FlashProve 用的是 zkSNARK,纯软件实现,不依赖可信硬件那一套 。流程拆成三段:
- 承诺(Commit):服务商先发布一个很短的“承诺 ID”,绑定唯一一组权重,权重本身仍然保密。
- 证明(Prove):对每一次完整的问答,GPU 生成一份证明,声称这些输出 token 就是那组被承诺权重的输出。
- 验证(Verify):手里有承诺、提示和回复的人,用普通 CPU 跑
cp_verify就能验,既不需要权重,也不需要 GPU 。
打个比方:它给你的不是菜谱,而是一张写着编号的封条。你拿着封条编号和端上来的菜,可以核对这道菜确实出自那本被封存的菜谱,但你看不到菜谱内容。零知识的意思就是,验证过程里权重和中间计算值都不会漏出去 。
工程上有个关键取巧:Maverick 是 MoE 结构,总参数约 4000 亿,但每个 token 只激活约 170 亿。证明的工作量按激活部分算,同时还能把“这次激活了哪些专家”藏起来 。这是它能塞进单张卡的原因。
那些具体数字,以及一个口径问题
110 tokens/s 这个数被反复引用,需要说清楚它到底指什么。仓库写的是“每批 24 个请求时,prefill 约 110 tokens/s” ;Unite.AI 的报道写成了“证明生成速度 110 tokens/s” 。两种说法不等价,采信仓库口径更稳。至于 decode 阶段的证明速度,本轮资料里没有数。
其余数字:单张 80GB H100,配约 290GB 主机内存;24 个请求一批约 223 秒,每条请求的证明约 18.78MB;离线承诺阶段约 39 分钟 。验证端下载约 6.5MB 的承诺文件,24 线程 17 秒、单线程 21 秒,包含离线阶段的检查 。仓库自带的示例证明检查 2 秒内就能出结果,但那是合成权重的小模型,只说明验证器能跑通,不代表真实模型的情况 。所以“CPU 几秒验证”这个说法得打个折:真实场景更接近 20 秒上下。
成本也得摆出来:和 8 张 H100 跑 vLLM FP8 推理相比,同样的批,证明消耗的每 GPU 时间约 72 倍,在最高负载下约 94 倍 。这东西不是免费挂上去的。
它保证什么,不保证什么
这部分最容易读错。
保证的是:Lean 4 里对完备性、可靠性和零知识做了形式化,一份假证明被接受的概率约为 q/2^124 + 2^-101 。而日常使用的那个快的 C++ 验证器本身没有形式化保证,只是和 Lean 验证器做过对测 。
不保证的是:覆盖范围是整数化权重下的贪心解码;浮点推理和采样解码会偏离被证明的那段计算;上下文上限 1024 token;时序等侧信道、针对性的对抗提示都不在保证内;没有独立安全审计 。
还有一个更根本的边界,很容易被“偷换便宜模型会被当场验出”这类说法盖过去。FlashProve 证明的是“这条回复出自被承诺的那组权重”,不是“那组权重没有被改过”。有人换了权重,他大可以重新发布一个新的承诺 ID,照样能通过验证。仓库文档专门提醒:承诺 ID 必须从你信任的第三方那里拿,绝不能来自被验证的那台服务器,也不能来自跟证明一起发过来的文件 。这句话是整套东西的信任根,也是它最不自动的地方。
另外,它也证明不了“同一块硬件没有同时在训练别的模型”。Anthropic 自己点出了这个限制,所以拿它去证明算力用途合规,能力是有限的 。
为什么“验证”忽然成了新问题
把 M014 那份研究放在旁边看,会更容易理解这件事的时机。
The Decoder 报道的 MIT 团队工作叫 Weight-Space Programming:利用 GPT-6 Astra 直接读写原始权重的能力,去改别的模型。最实用的一组实验里,Qwen3.5-0.8B 只改了 0.016% 的权重,MATH-500 从 7.9% 提到 48.1%,指令遵循从 21% 到 62%,陷入思考循环的比例从 93% 降到 33% 。对照的 Gemma 3 270M 因为本来不太循环,测不出提升;在 Breakout 上,Astra 直接写出来的权重平均 517 分,常规训练 1 亿轮的基线是 25 分,另两个游戏又落后于训练最久的版本 。研究者自己的解释是,他们怀疑拆掉了 Qwen 里抑制已有能力的一道堵塞,而模型本来不具备的技能,没法靠这种方式凭空加上 。Schmidhuber 在 X 上说这是“旧闻”,引了自己 1990 年代的工作;Khattab 回应说论文里引了,新意在今天的大模型能在人类语言和数值权重之间来回翻译 。
需要标注的是:这些数字都来自 The Decoder 的转述,原始论文和实验日志本轮没有读到,Astra 与 OpenAI 的官方口径也没有核对。
这两件事没有因果关系,别硬接成一条宏大叙事。但它们指向同一件事的两面:权重比过去更容易被针对性改动、被局部微调、被“拆堵塞”,那么“我收到的这条回复出自哪份权重”就不再是个哲学问题,而是采购、评测、监管都会问的问题。FlashProve 给出的是一种回答方式:把回复和一份具体的权重绑在一起,让第三方在不看权重的前提下核对。
顺带一个值得玩味的细节:项目文档记录,几乎全部代码、Lean 证明和文档,以及所报告的测试,都是 AI 系统在人类指导下完成的 。用 AI 写出来的验证工具去验证 AI 的输出,这个环能不能闭上,现在没人敢打包票。
我的判断
值得看重的是方向。过去我们判断一个模型服务,靠的是“输出看起来对不对”,那是间接证据;密码学证明把问题换成了“这段输出是不是这份权重的函数”,这是直接证据。对独立评测、对“我买到的究竟是不是那个模型”这类需求,这是质的不同。
但也要清楚它现在站在哪里:不维护的研究原型、1024 token 上下文、只覆盖贪心解码、证明成本 72~94 倍、没有独立审计、承诺 ID 的获取仍然是个靠人的信任环节。它不是“从今天起偷换模型就藏不住了”,而是“这条路第一次被走到能在真实大模型上跑、能在普通 CPU 上验”的程度。
真正的转折点会落在两个数上:证明成本能压到什么水平;承诺的发布和核验能不能进入现有的采购与审计流程,而不是停在文档里那句“请相信这个 ID”。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] Anthropic Releases FlashProve for Cryptographic AI Inference Proofs
- [S2] The Decoder
- [S3] New: cryptographic proof of which AI model actually answered you. AI, explained Ep9: Anthropic's FlashProve attaches a p · Eliran Emuna
- [S4] GPT-6 Astra sees the matrix and reprograms other AI models directly through their weights
- [S5] GitHub - anthropics/FlashProve: A research prototype for zero-knowledge proofs of AI inference. Not maintained.
- 配图 1:来源:Unite.AI(图片署名见原文) · 图片出处
- 配图 2:来源:Unite.AI(图片署名见原文) · 图片出处
- 配图 3:来源:Unite.AI(图片署名见原文) · 图片出处
- 配图 4:来源:Unite.AI(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。